最終更新:2026-10-12
Helgrind 並行エラー検出
C++那些事のhelgrind並行プログラミング検出
マルチスレッドプログラムを書いているとき、私たちはよく2つの問題に遭遇します:
- デッドロックが発生したが、原因がわからない
- データの不整合、複数スレッドでのロックの使い方を間違えた
では、この2つのシナリオを検出できるツールはあるのでしょうか?
答えはあります。valgrindのhelgrindツールを使ってこの2つの問題を検出できます。本記事の解説をよりスムーズに進めるため、いくつかの例を用意しました。
注:完全なサンプルおよび修正済みサンプルは知識星球で更新済みです。
デッドロック
2つのスレッドが互いに相手のロックを保持していると仮定すると、デッドロックを再現できます。例えば:
void thread_func1() {
    std::lock_guard<std::mutex> lock1(mutex1);
    std::this_thread::sleep_for(std::chrono::milliseconds(100));
    std::lock_guard<std::mutex> lock2(mutex2);
}

void thread_func2() {
    std::lock_guard<std::mutex> lock2(mutex2);
    std::this_thread::sleep_for(std::chrono::milliseconds(100));
    std::lock_guard<std::mutex> lock1(mutex1);
}
helgrindの使用方法は次のとおりです:
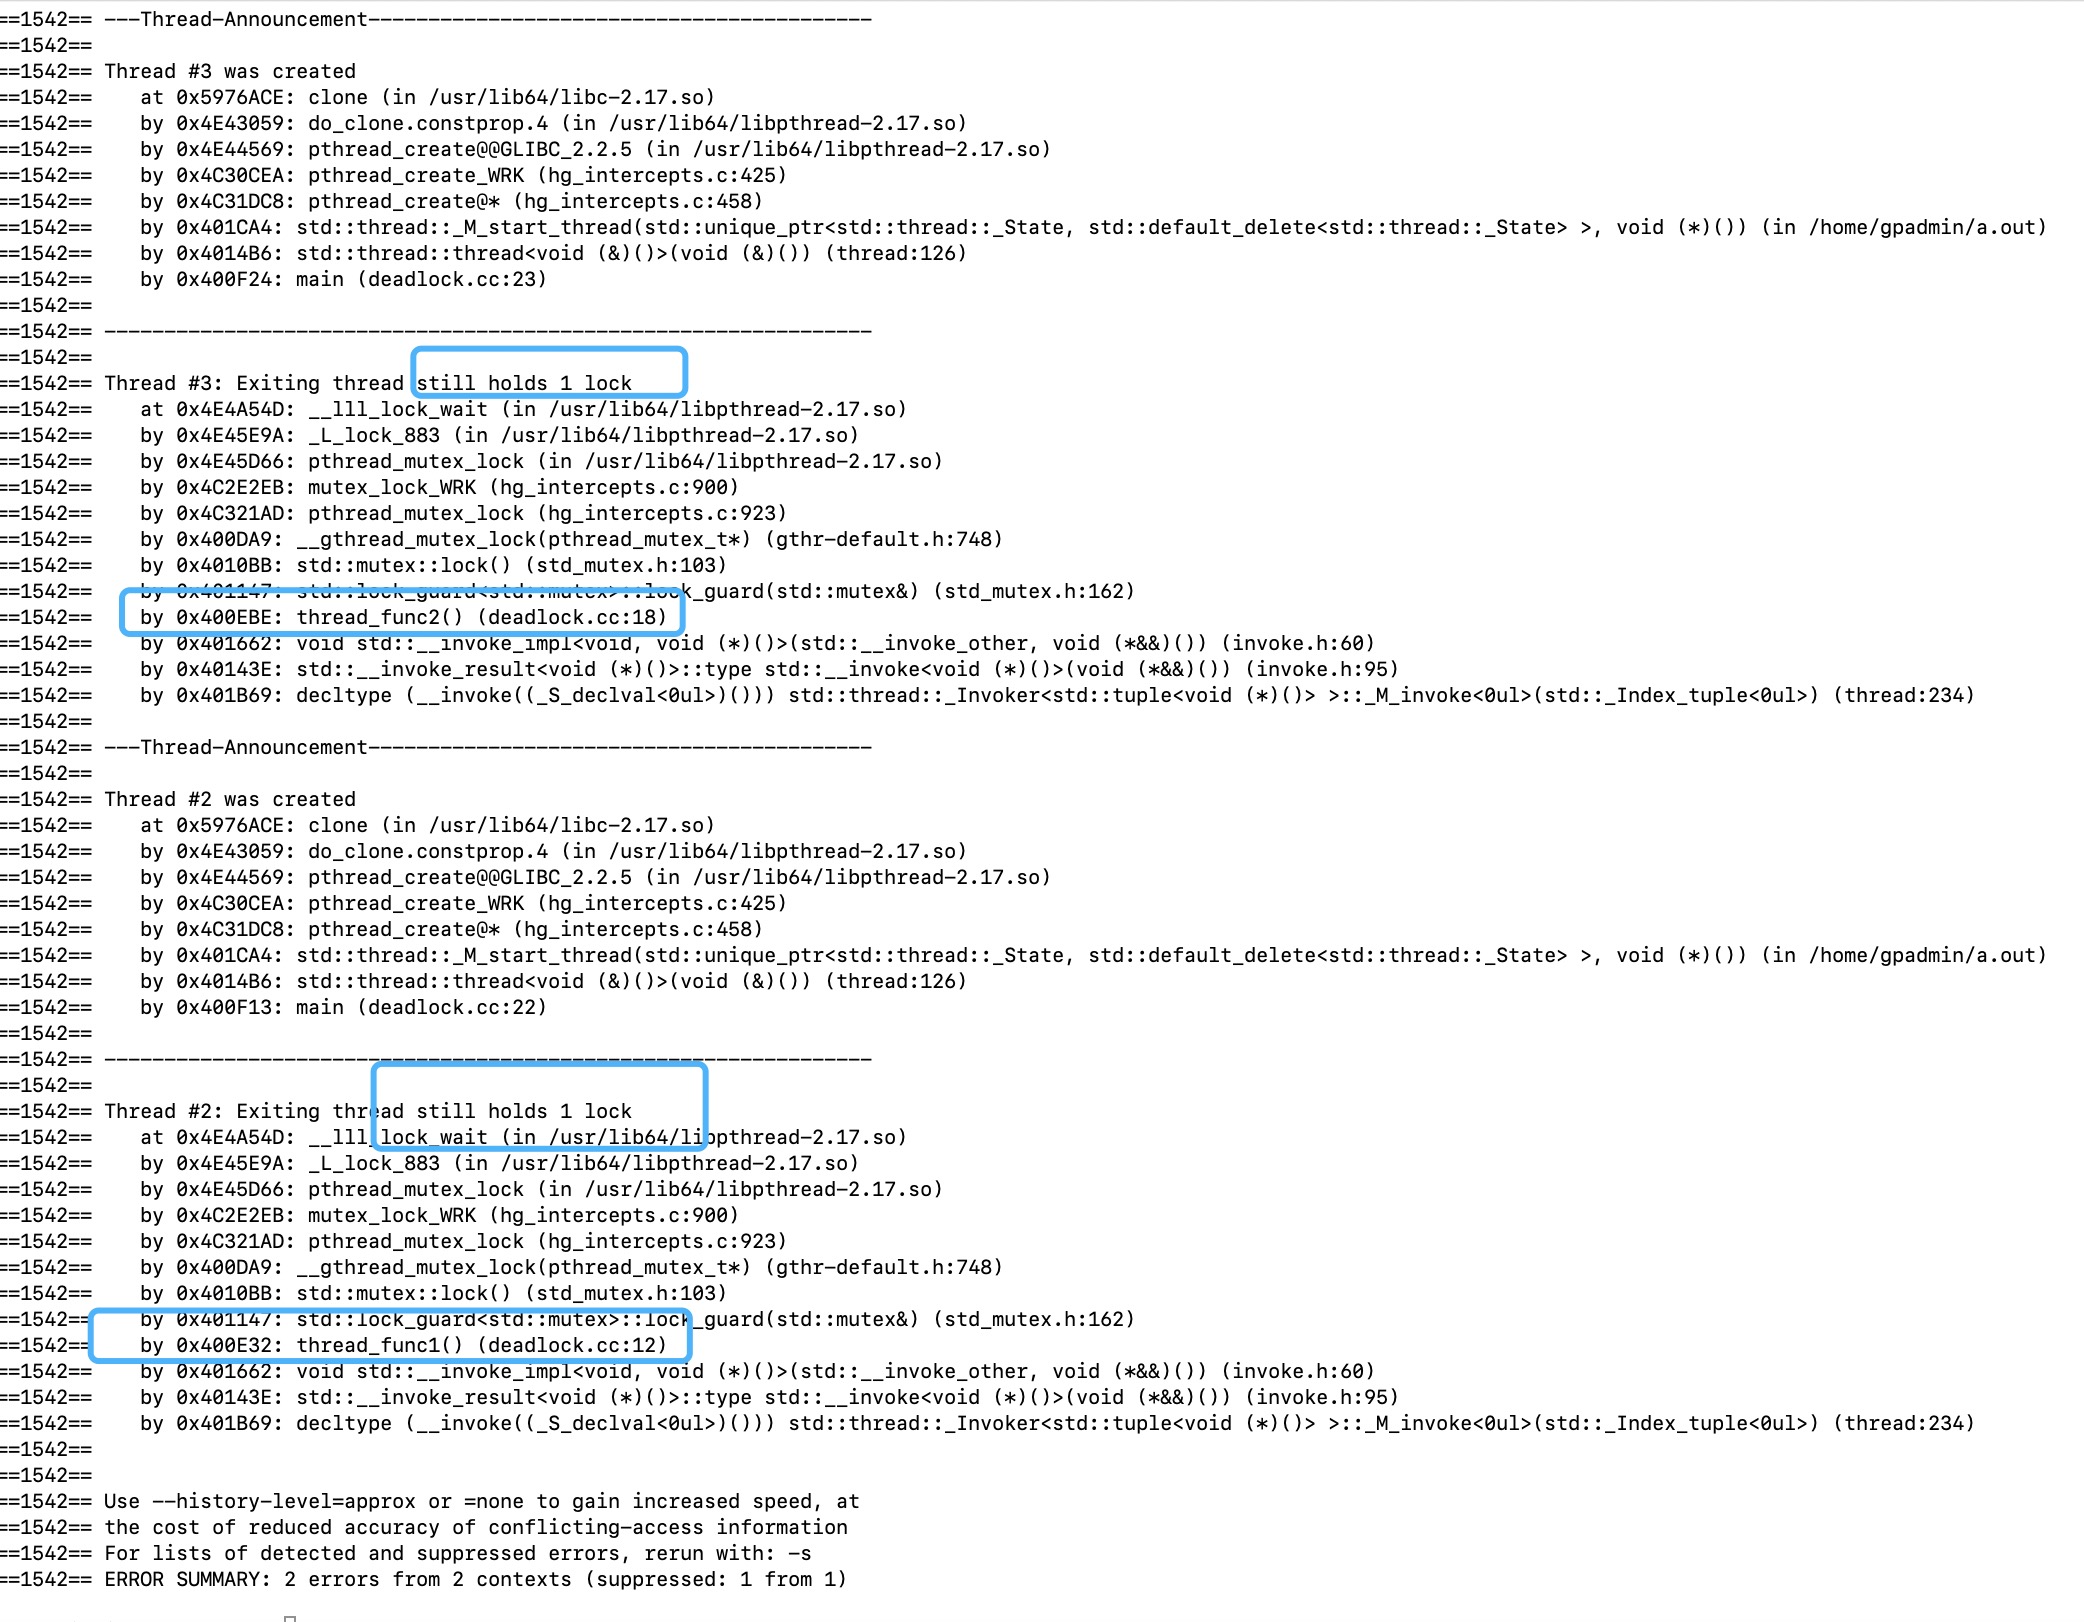
このとき、デッドロックが発生した位置を確認できます。例えばこのサンプルでは、2つのスレッドが対応する位置でデッドロックを起こしたことが指摘されています。
データ競合
ある共有変数があり、複数スレッドでそれを10万回インクリメントすると、結果はいくつになるでしょうか?
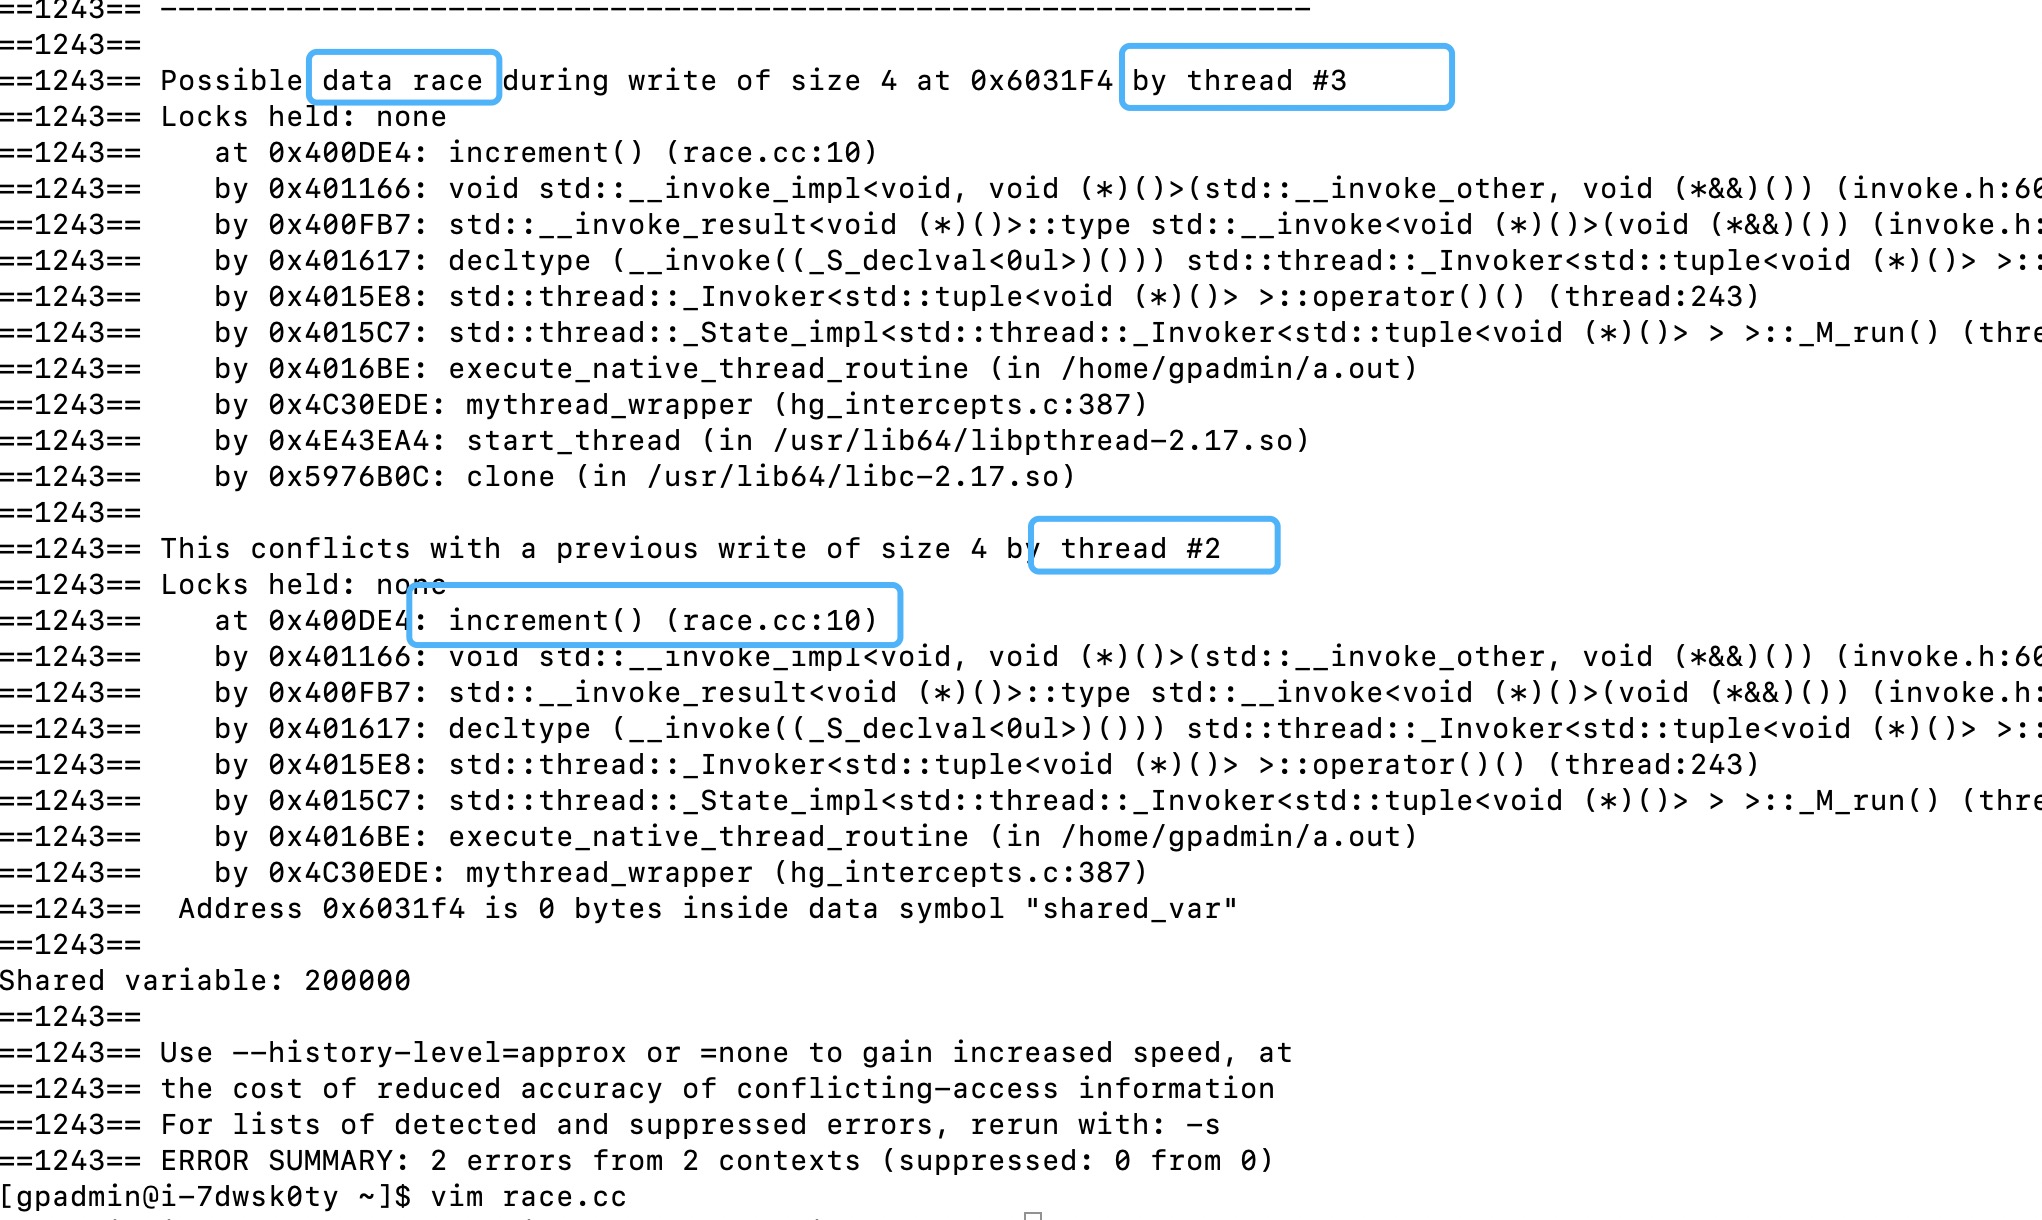
明らかに、ここでは複数スレッドがグローバル変数を奪い合う問題が発生しており、最終的な結果は一致しません。helgrindによる検出方法は上記と同じです。
このとき、data raceが発生したのがどの行かを確認して、問題を解決しに行くことができます。
最後に、いくつか問題を残しておきましょう:
1.上記の2つの問題のあるコードは、どのように修正すればよいでしょうか?
2.上記のツール以外に、他の方法はあるでしょうか?
本節は以上です
関連トピック
- C++ Concurrency in Action 読書ガイド | C++那些事
- C++ デッドロック調査 | C++那些事
- C++ SIMD ベクトル化 | C++那些事
- C++17 並列 STL | C++那些事
- C++ False Sharing とキャッシュライン | C++那些事
- GDB マルチスレッド All-Stop デバッグ | C++那些事
- libev イベントループの原理 | C++那些事
- C++ std::thread の内部実装 | C++那些事
- C++ std::thread と jthread | C++那些事
- C++ マルチスレッド入門 | C++那些事