最終更新:2026-10-12
STL traits 型の抽出
0.はじめに
STL プログラミングでは、コンテナとアルゴリズムは独立に設計されています。すなわち、データ構造とアルゴリズムが独立に設計されており、コンテナとアルゴリズムをつなぐ橋がイテレータです。イテレータによってこの独立した設計が可能になっています。下図に示す通りです:
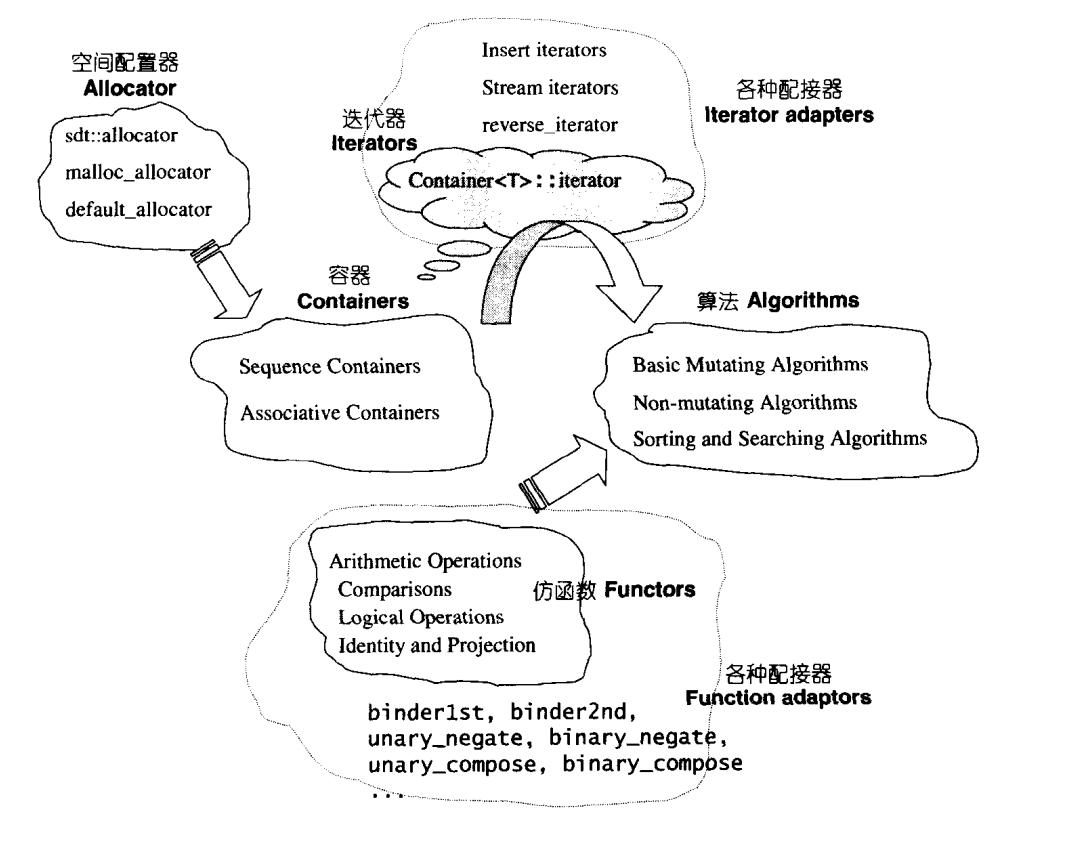
上図が示すのは、STL の目標がデータとアルゴリズムを分離してそれぞれ設計し、その後 iterator という名のものによって両者を再び接着することです。
デザインパターンにおける iterator の説明は次の通りです:コンテナ内の各要素に順番にアクセスする方法であり、この方法を使ってもコンテナ内部の表現方法は露出しない。型の抽出(traits)技術は、まさに iterator に関わる問題を解決するためのものです。
汎用アルゴリズム(find, count, find_if)を何らかのコンテナに対して使うには、最も重要なのはアルゴリズムにコンテナ要素へアクセスする道具を提供することであり、iterator がこの重要な役割を担っています。
アルゴリズムの中では、簡単な中間変数を定義したり、アルゴリズムの戻り値の型を設定したりすることがあります。その際、イテレータが指す要素の型が何かを知る必要がありますが、typeof のような型を判断する関数がないため、直接取得することができません。どうすればよいのでしょうか?本記事で具体的に説明します。
イテレータは一種のスマートポインタのようなものであり、したがって一般のポインタが持つすべての特徴——*と->の操作ができる——を備えています。しかし、コンテナを走査するとき、走査するコンテナ内部についてある程度知らなければなりません。そこで、いっそのことイテレータの開発作業をコンテナの設計者に任せてしまえば、すべての実装詳細はかえってカプセル化され、使用者から見えなくなります。これこそ、すべての STL コンテナが専用のイテレータを提供している理由です。
Traits はbits/stl_iterator_base_types.hにあります:
template<class _Tp>
struct iterator_traits<_Tp*>
{
    typedef ptrdiff_t difference_type;
    typedef typename _Tp::value_type value_type;
    typedef typename _Tp::pointer pointer;
    typedef typename _Tp::reference reference;
    typedef typename _Tp::iterator_category iterator_category;
};
見てもちんぷんかんぷんでしょう。大丈夫、この節を読み終えれば STL 入門です、哈哈~
1.template パラメータ推論
まず、アルゴリズムでイテレータを使うとき、その関連型(associated type)(イテレータが指すものの型)を使うことが多いでしょう。アルゴリズムの中で「イテレータが指すオブジェクトの型」を型とする変数を宣言する必要がある場合、どうすればよいでしょうか?
解決方法は、function template のパラメータ推論機構を利用することです。
例えば:
T が特定のオブジェクトへのポインタであるとき、func の中でポインタが指すオブジェクトの型が必要になったら、どうすればよいでしょうか?これは比較的簡単で、テンプレートのパラメータ推論機構がこのタスクを完了できます。
template <class I>
inline
void func(I iter) {
    func_impl(iter, *iter); // 传入iter和iter所指的值,class自动推导
}
テンプレートの推論機構によって、ポインタが指すオブジェクトの型をいとも簡単に取得できました。
template <class I, class T>
void func_impl(I iter, T t) {
        T tmp; // 这里就是迭代器所指物的类别
        // ... 功能实现
}

int main() {
    int i;
    func(&i);
}
しかし、関数の「template パラメータ推論機構」が推論できるのはパラメータだけで、関数の戻り値の型は推論できません。もし関数の戻り値を推論する必要が出てきたら、お手上げです。そこで、次の方法が登場します。
2.ネストした型の宣言
イテレータが指すオブジェクトの型を、イテレータの value type と呼びます。
func_impl の中では T を関数の戻り値にできますが、問題はユーザーが呼び出す必要があるのは func だという点です。
template <class I, class T>
T func_impl(I iter, T t) {
        T tmp; // 这里就是迭代器所指物的类别
        // ... 功能实现
}
template <class T>
(*T) func(T t) { // !!!Wrong code
    return func_impl(t, *t); // forward the task to func_impl
}
int main() {
    int i  =10;
    cout<<func(&i)<<endl; // !!! Can’t pass compile
}
上記のコードをコンパイルすると、コンパイルに失敗します!
この問題の解決も難しくありません。ネストした型を宣言するのがよいアイデアのようです。そうすれば直接取得できます。iterator を作り、その定義の中で指すオブジェクトの型に別名を付ければよいのです。次のようにします:
template <class T>
struct MyIter {
    typedef T value_type; // 内嵌型别声明
    T* ptr;
    MyIter(T* p = 0) : ptr(p) {}
    T& operator*() const { return *ptr; }
};

template <class I>
typename I::value_type
func(I ite) {
    std::cout << "class version" << std::endl;
    return *ite;
}
int main() {
    // ...
    MyIter<int> ite(new int(8));
    cout << func(ite);  // 输出8
}
非常に美しい解決策で、すべてが完璧に見えます。しかし、実際にはまだ問題があります。func が汎用アルゴリズムであるなら、生ポインタ(ネイティブポインタ)もイテレータとして受け入れなければなりません。しかし、明らかに次のコードをコンパイル通すことはできません:
私たちの func は生ポインタをサポートできません。これは明らかに受け入れられません。ここで、template partial specialization(テンプレートの部分特殊化)が役に立ちます。
3.救世主 Traits
前述の通り、typename I::value_typeを直接使うと、アルゴリズムは生ポインタを受け取れなくなります。生ポインタには value_type というネストした型がそもそもないからです。
そこで、さらに中間層を入れて、それが生ポインタかどうかを判断する必要があります。注目してください、これこそ traits 技法の妙ところです。
上の做法、すなわち value_type をネストするだけだと、value_type を持たないポインタに対しては部分特殊化するしかありません。これは呼び出し可能な関数 func に対する部分特殊化です。もし func が100万行のコードを持っていたら、極めて大きな視覚的汚染を引き起こします。
(1)関数の部分特殊化
関数の部分特殊化:
template <class T>
struct MyIter {
    typedef T value_type; // 内嵌型别声明
    T* ptr;
    MyIter(T* p = 0) : ptr(p) {}
    T& operator*() const { return *ptr; }
};

template <class I>
typename I::value_type
func(I ite) {
    std::cout << "class version" << std::endl;
    return *ite;
}
template <class I>
I
func(I* ite) {
    std::cout << "pointer version" << std::endl;
    return *ite;
}
template <class I>
I func(const I* ite) {
    std::cout << "const pointer version" << std::endl;
    return *ite;
}
int main() {
    // ...
    MyIter<int> ite(new int(8));
    cout << func(ite)<<endl;
    int *p = new int(52);
    cout<<func(p)<<endl;
    const int k = 3;
    cout<<func(&k)<<endl;
}
出力:
(2)中間層を入れる
STL における Traits とは何でしょうか?下図を見てください:
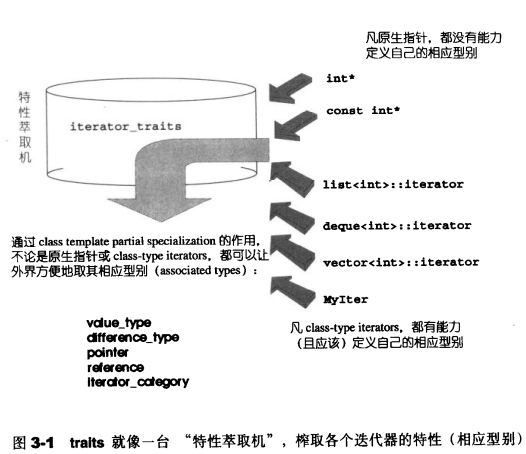
中間層iterator_traitsを利用してfuncの形式を固定し、重複したコードを大幅に減らしています。しなしなければならないのは、iterator_traits を少し特殊化して pointer と const pointer をサポートすることだけです:)
#include <iostream>

template <class T>
struct MyIter {
    typedef T value_type; // 内嵌型别声明
    T* ptr;
    MyIter(T* p = 0) : ptr(p) {}
    T& operator*() const { return *ptr; }
};
// class type
template <class T>
struct iterator_traits {
    typedef typename T::value_type value_type;
};
// 偏特化1
template <class T>
struct iterator_traits<T*> {
    typedef T value_type;
};
// 偏特化2
template <class T>
struct iterator_traits<const T*> {
    typedef T value_type;
};

template <class I>
typename iterator_traits<I>::value_type
// 首先询问iterator_traits<I>::value_type,如果传递的I为指针,则进入特化版本,iterator_traits直接回答;如果传递进来的I为class type,就去询问T::value_type.
func(I ite) {
    std::cout << "normal version" << std::endl;
    return *ite;
}
int main() {
    // ...
    MyIter<int> ite(new int(8));
    std::cout << func(ite)<<std::endl;
    int *p = new int(52);
    std::cout<<func(p)<<std::endl;
    const int k = 3;
    std::cout<<func(&k)<<std::endl;
}
上記の過程は、まずiterator_traits<I>::value_typeに尋ねるというものです。渡された I がポインタであれば特殊化バージョンに入り、iterator_traitsはTと直接答えます。渡されたIがclass typeであれば、T::value_typeに尋ねに行きます。
上記を平たく説明すると、アルゴリズム(func)が iterator_traits(私)に尋ねるが、iterator_traits(私)は手にあるのがポインタだと気づいたときは、私が代わりに答えます。class type であれば、iterator_traits(私)はさらに(彼---T::value_type)に尋ね続けます。
まとめ:ネストした型を定義することで、iterator が指す要素の型を知る方法を得ました。traits 技法によって、関数テンプレートの生ポインタとカスタム iterator に対する定義を統一しました。traits 技法を使う主な目的は、生ポインタとカスタム iterator の違いによって生じるコードの冗長性を解決することであり、これこそ traits 技法の妙ところです。
学習書籍:
侯捷《 STL 源码剖析》
学習記事:
https://juejin.im/post/5b1a43fb51882513bf1795c6
関連トピック
- STL array ソースコード解析 | C++那些事
- STL string 深入解析 | C++那些事
- STL string 面接問題解説 | C++那些事
- STL deque ソースコード解析 | C++那些事
- STL 空基底クラス最適化 EBO | C++那些事
- STL 手書きハッシュテーブル実装 | C++那些事
- STL hashtable ハッシュテーブル | C++那些事
- STL イテレータソースコード解析 | C++那些事
- STL list ソースコード解析 | C++那些事
- STL map と multimap | C++那些事