最終更新:2026-10-12
C++17 並列 STL
1.各コンパイラの対応状況
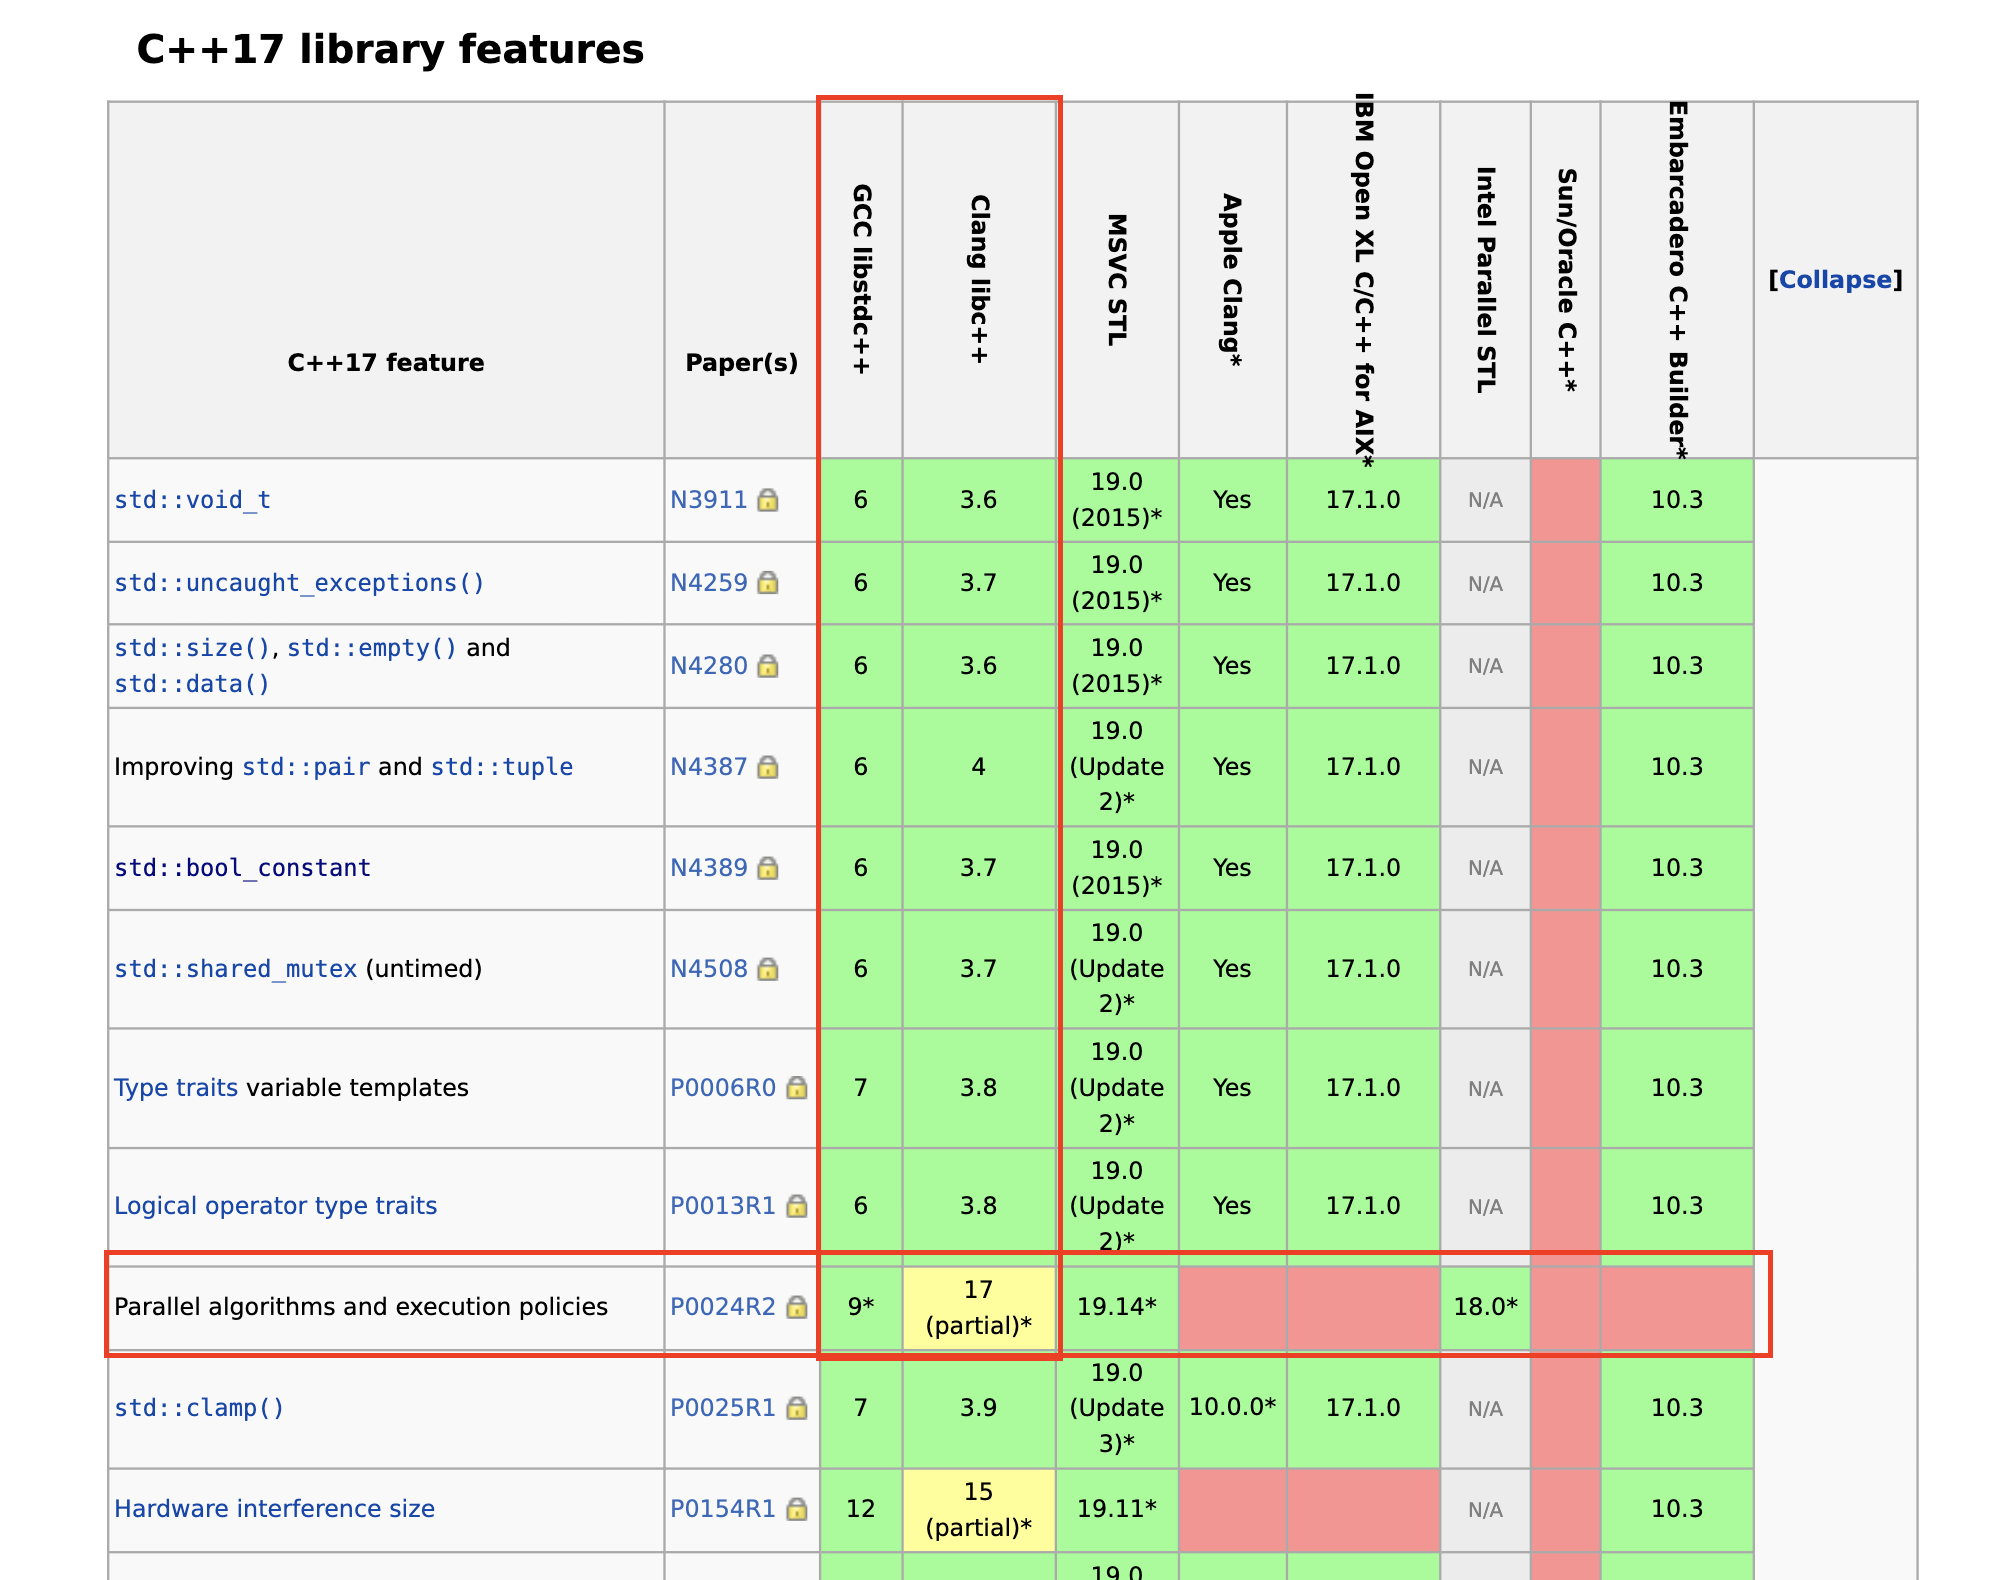
各コンパイラの並列アルゴリズムライブラリへの対応状況は以下のとおりです:
https://en.cppreference.com/w/cpp/compiler_support/17#C.2B.2B17_library_features
gcc9以降で対応済みであることがわかります。clangはまだ完全には対応しておらず、自分でもローカルで試しましたが、確かに未対応でした。
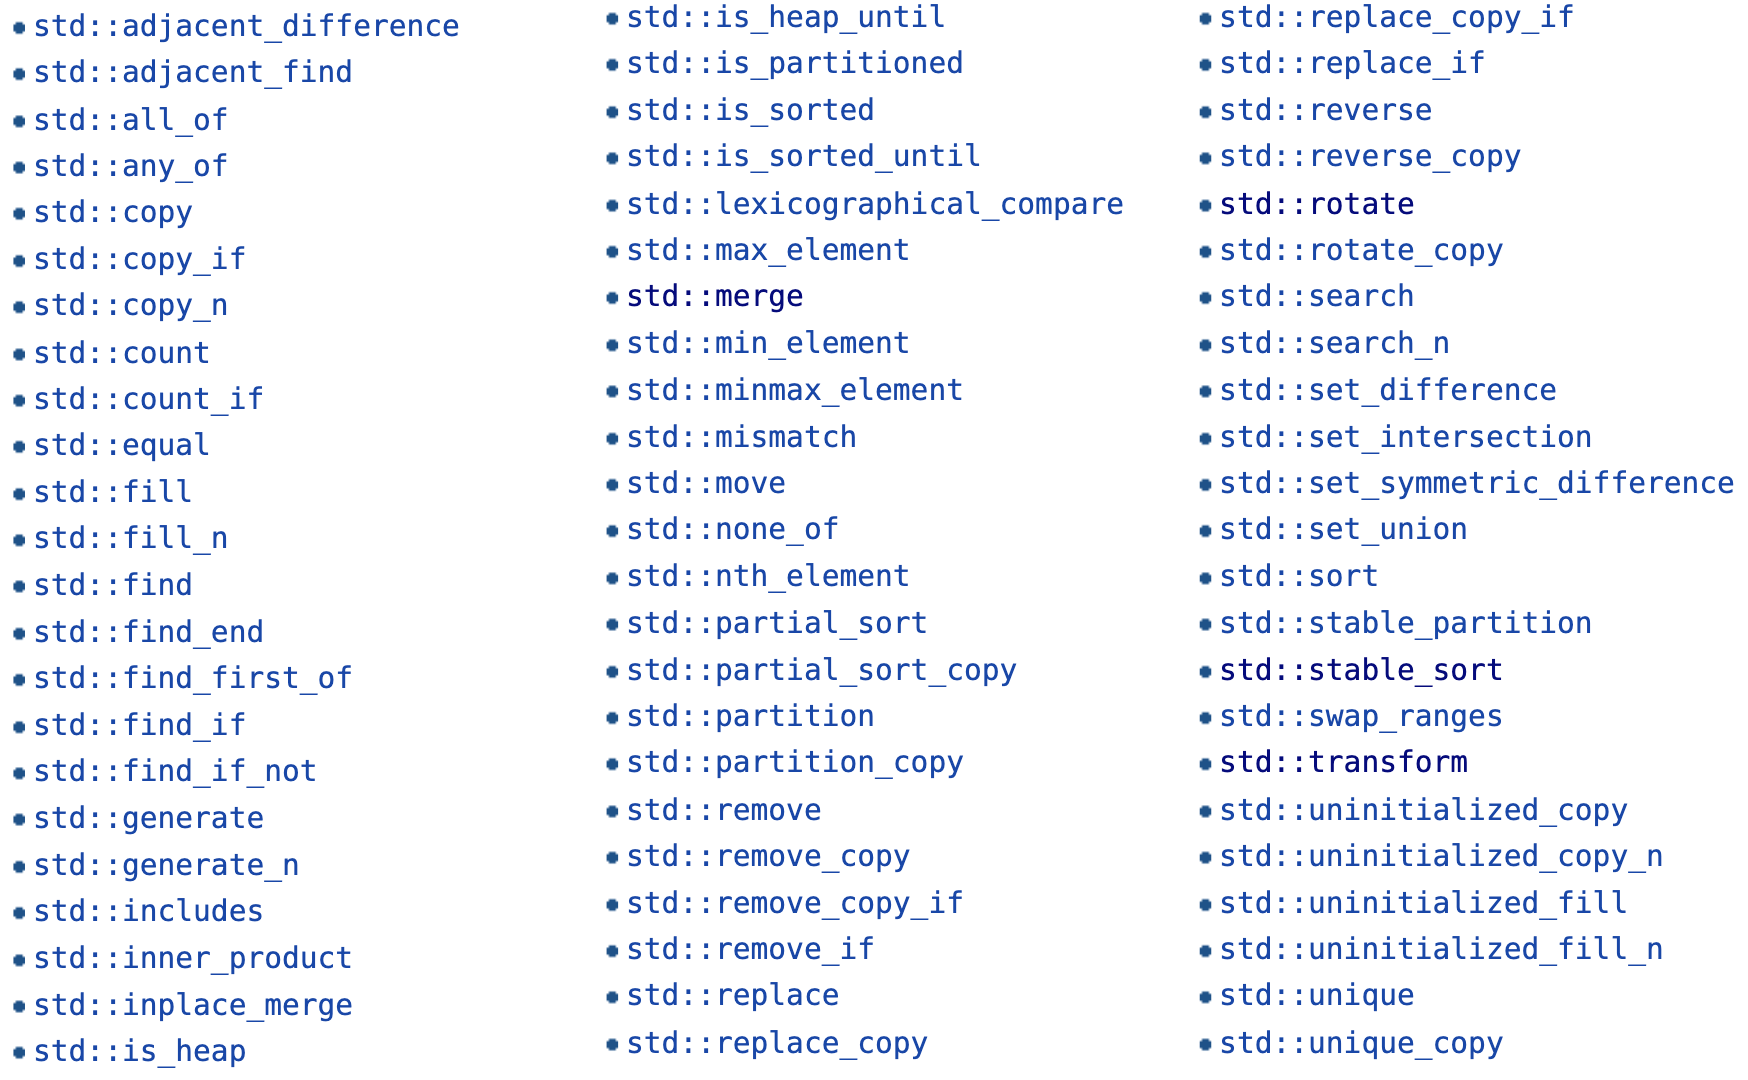
対応しているアルゴリズムには以下が含まれます:
2.並列アルゴリズムライブラリの要件
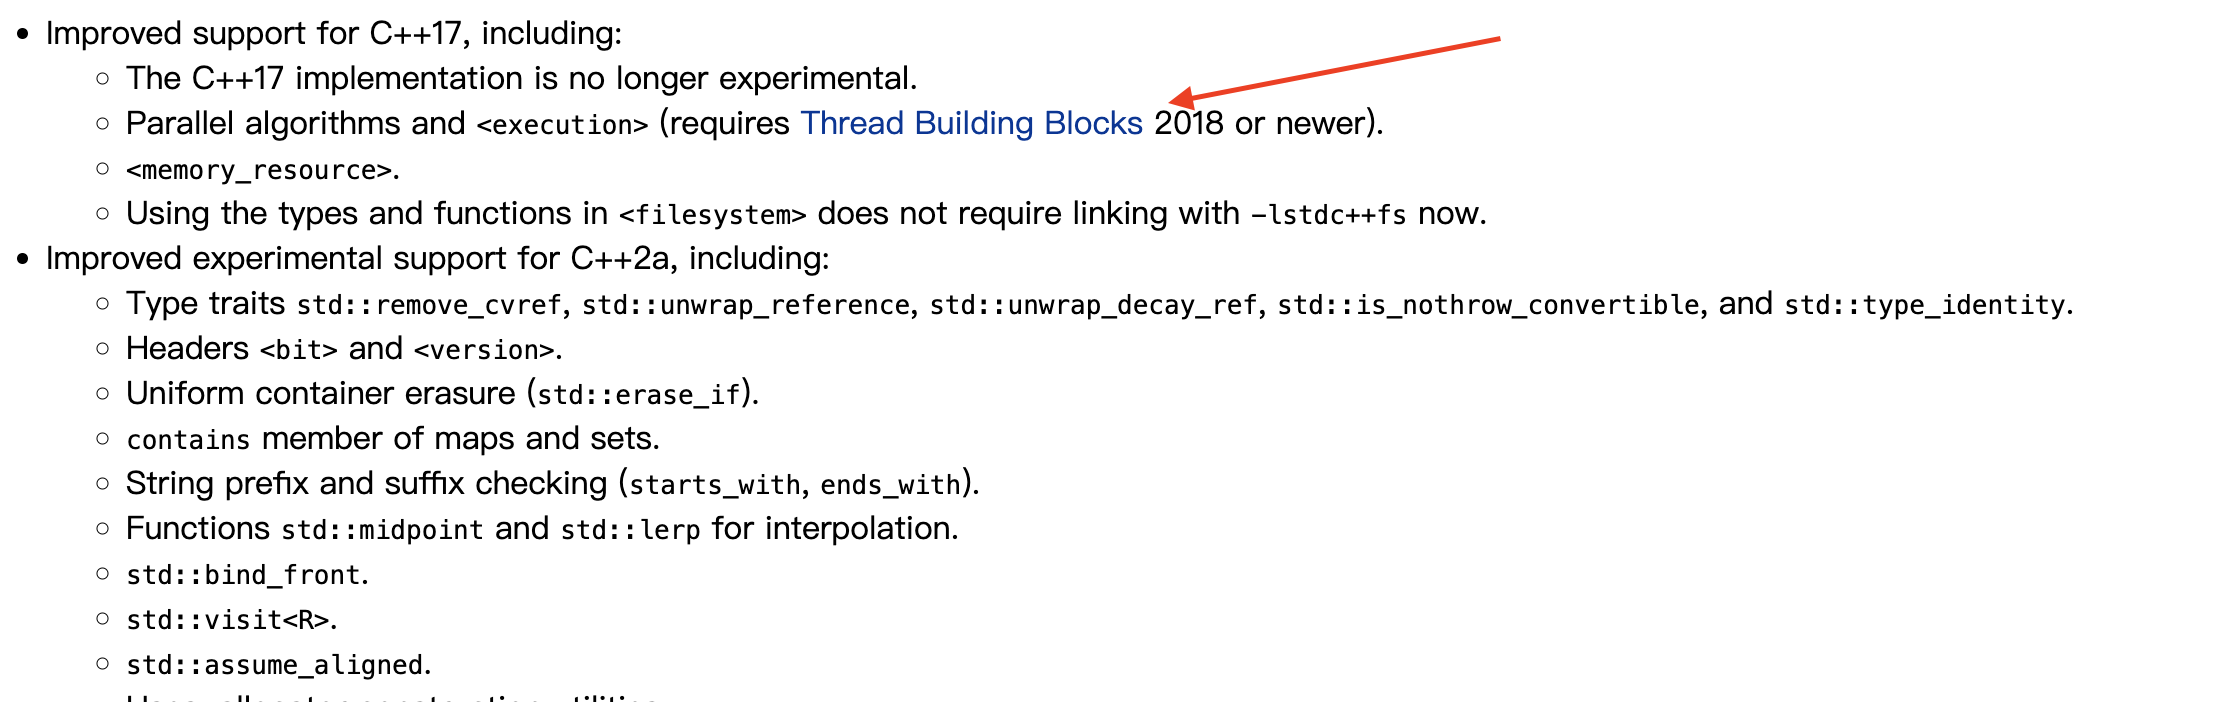
gcc9以降なら並列アルゴリズムライブラリを使用できます。以下のgcc-9のドキュメントを見てみましょう。
その中で、非常に重要な情報が述べられています:**tbbサポートが必要**です。
TBBはインテル(Intel)社が開発した並列プログラミング用のC++ライブラリです。TBBは、マルチコアプロセッサ上での並列ソフトウェア開発を簡素化することを目指しており、プログラマが並列アルゴリズムをより簡単に実装できるよう、一連の抽象化とモデルを提供しています。
1.C++17で並列アルゴリズムライブラリを使用する前提としてtbbをインストールする必要がありますが、tbbをインストールしないとどうなるのでしょうか?
自分で実際に試したところ、コンパイルと実行は可能でしたが、一切高速化されず、従来の非並列実行の結果と同じでした。
2.TBBはどのようにインストールするのでしょうか?
1つは公式のtbbで、oneTBBと呼ばれます。
もう1つは他の人が書いたtbbで、tbbと呼ばれます。
違いは、CMakeベースのビルドシステムが追加されている点です。
現在は公式でもcmakeをサポートしているので、公式のものを使うことをおすすめします。
コンパイルも非常に簡単です:
3.使い方
従来のSTLの使い方と比べて、どのような変更点があるのでしょうか?
1.インターフェース面
実はとても簡単です。例えば、sortは元々次のように書いていました:
これが次のように変わります:
実行ポリシー(execution policy)を追加するだけで、選択肢は3つあります:
std::execution::seq(逐次実行):- これがデフォルトの実行ポリシーです。つまり、実行ポリシーを明示的に指定しない場合、アルゴリズムは逐次実行を使用します。
- アルゴリズムは要素を順番に処理し、並列処理は行いません。
std::execution::par(並列実行):- この実行ポリシーを使用すると並列実行が有効になります。アルゴリズムは要素を並列に処理しようとし、マルチコアプロセッサをフルに活用します。
std::execution::par_unseq(並列およびベクトル化実行):- この実行ポリシーは、アルゴリズムが並列であると同時にベクトル化(vectorization)を行うことを許可します。つまり、SIMD(Single Instruction, Multiple Data)命令セットを利用した並列ベクトル化演算が可能になります。
std::execution::parとは異なり、par_unseqは並列処理に加えてベクトル化処理も許可するため、ハードウェアの並列化・ベクトル化能力をより一層フルに活用できます。
2.ヘッダファイル面
次のヘッダを必ずインクルードする必要があります:
tbbの操作がある場合は、tbbのヘッダファイルをインクルードできます。例えば:スレッド数の設定です。
3.コンパイル面
コンパイル時にリンク情報を指定する必要があります。例えば:
g++ -O3 -std=c++17 -Wall -Wextra -pedantic -I/usr/local/include/tbb -L /usr/local/lib/ -o main.out main.cc -ltbb
4.パフォーマンステスト
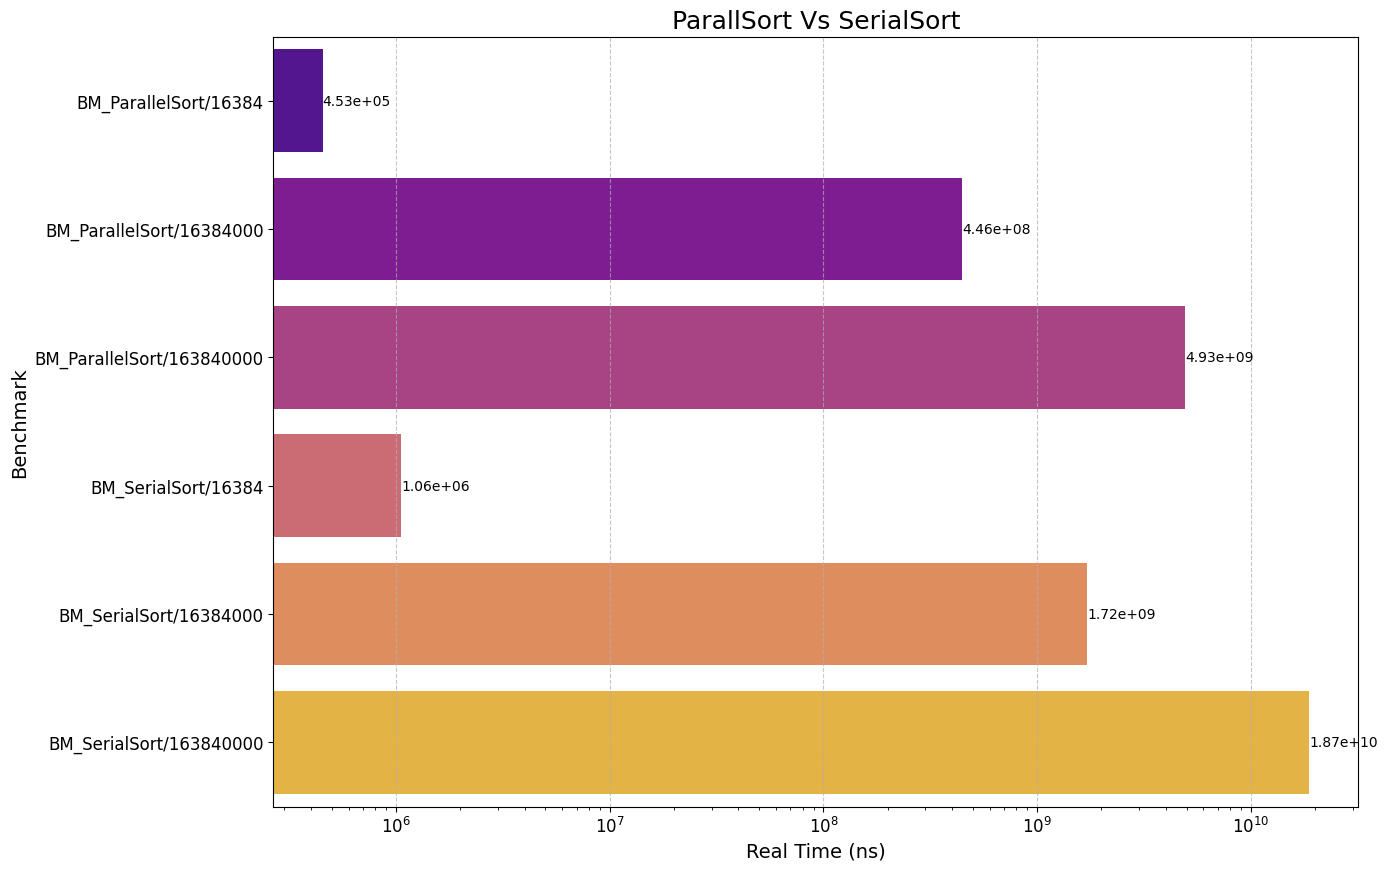
最近sort関連の作業をしていて、mergeとsortのパフォーマンスを確認したくなったため、benchmarkを書きました。ロジックは次のとおりです:
-
逐次sort vs 並列sort(parポリシー)
-
逐次merge vs 並列merge(parポリシー)
データ範囲:
以下のテスト結果では、tbbのデフォルトのスレッドスケジューリングポリシーを使用します。
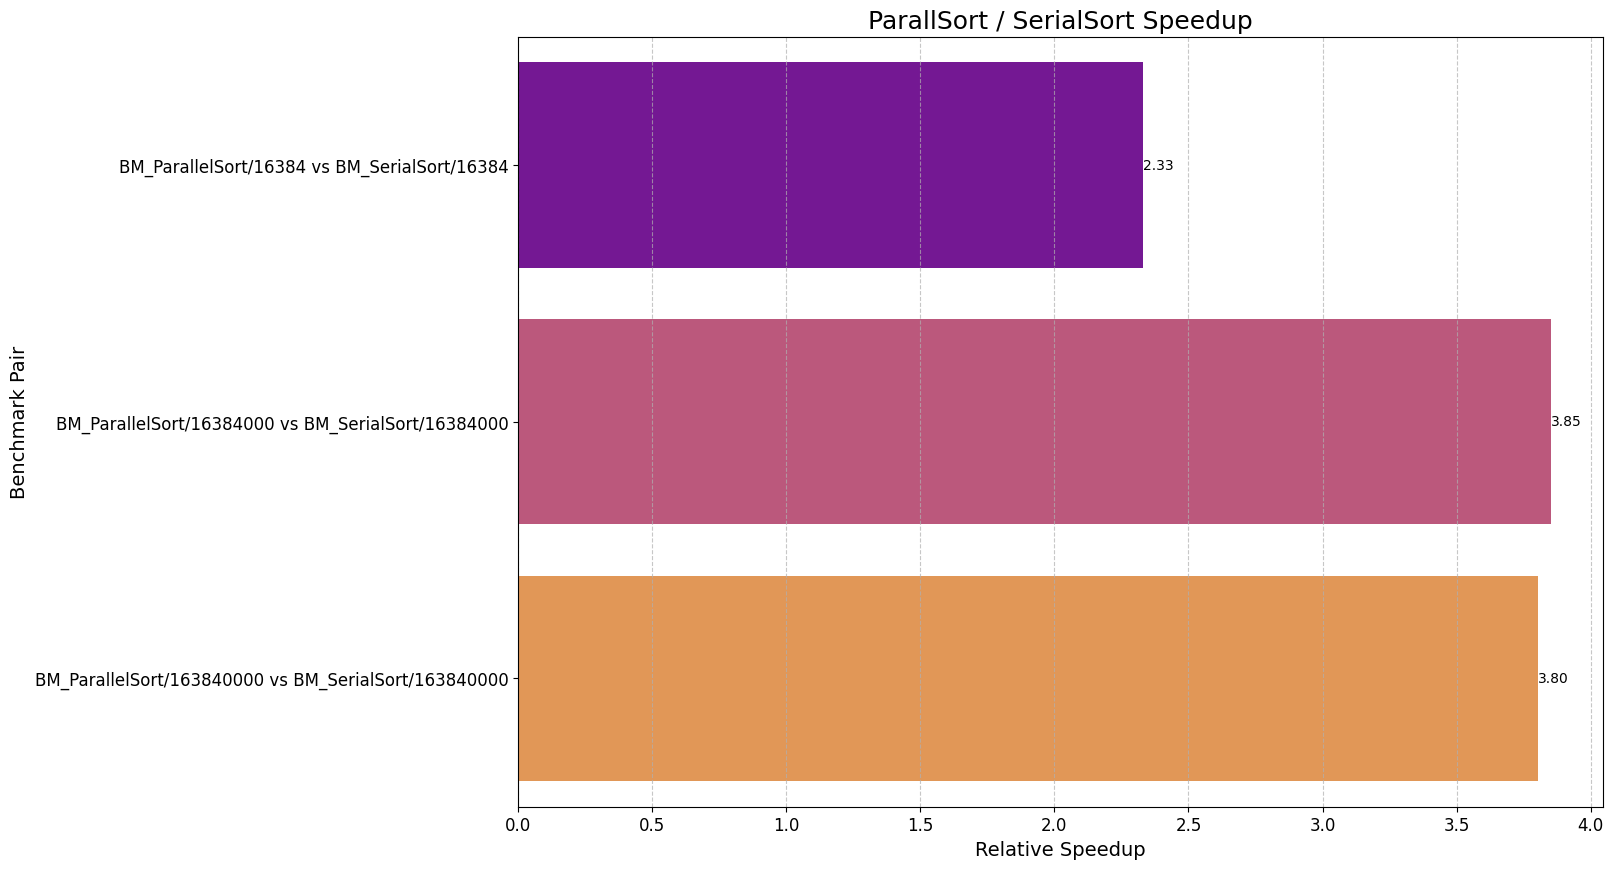
対照グループ1:並列Sort/逐次Sortの詳細データと高速化比
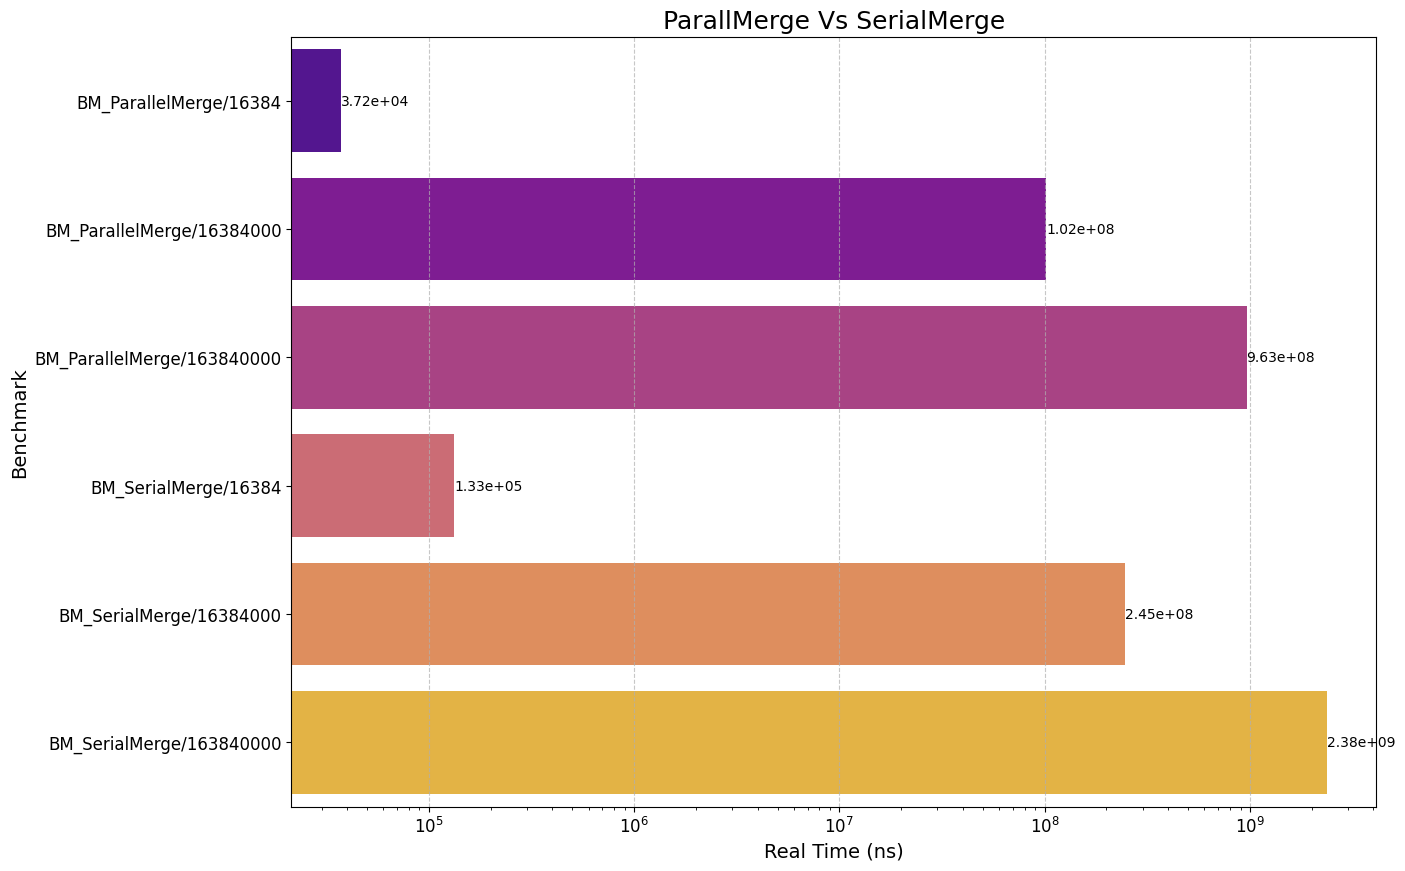
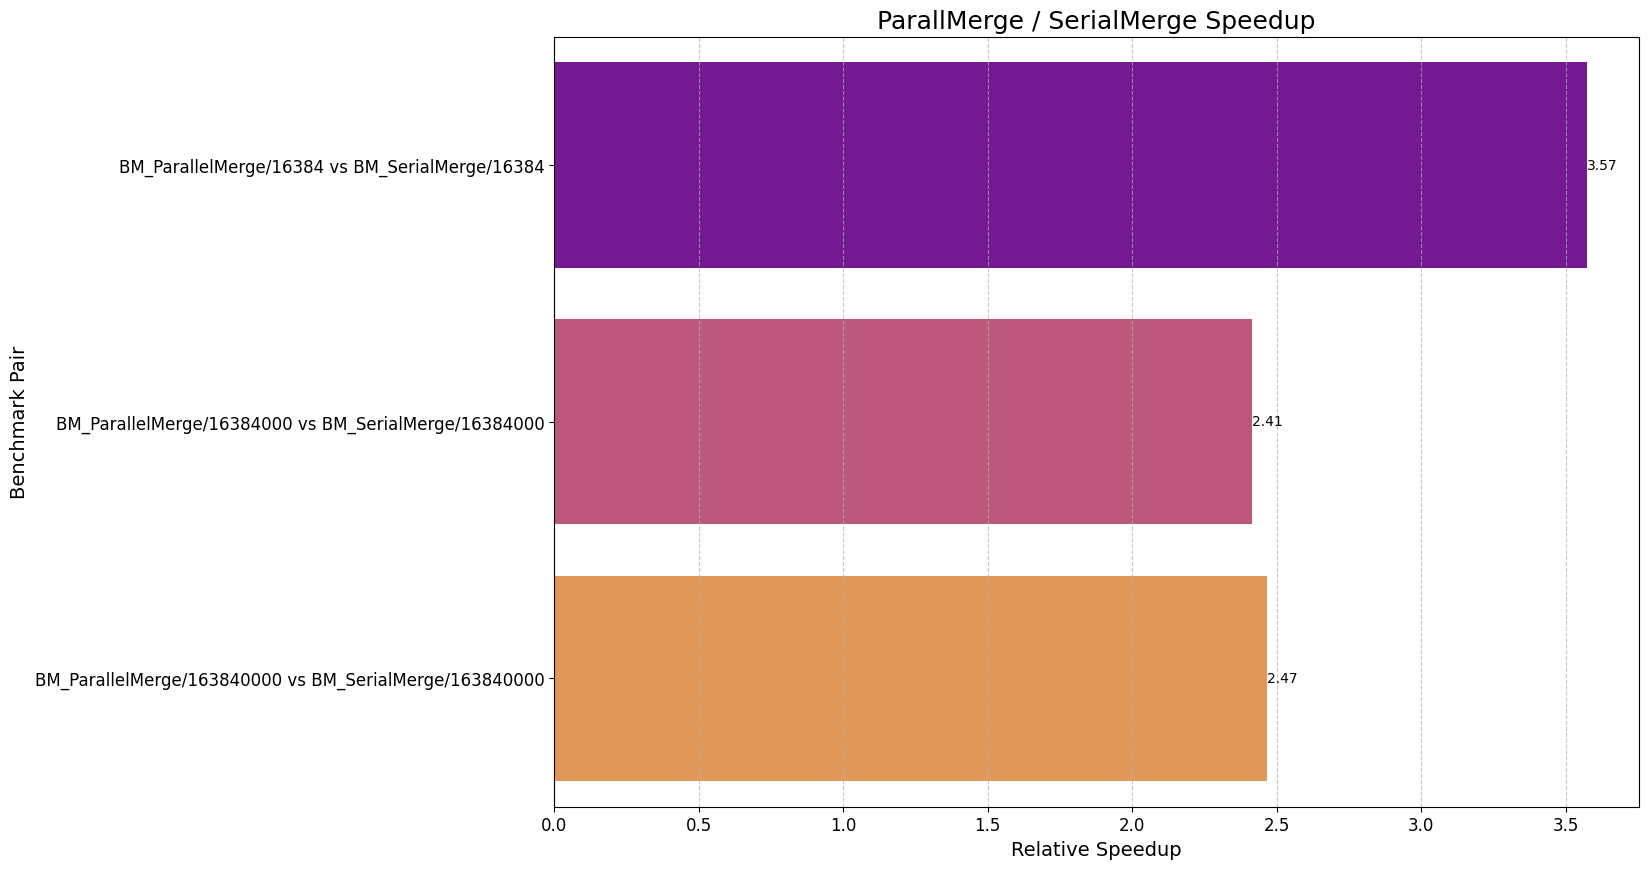
対照グループ2:並列Merge/逐次Mergeの詳細データと高速化比
tbbドキュメント:
スレッド数を設定したい場合は、次のように操作できます:
関連トピック
- C++ Concurrency in Action 読書ガイド | C++那些事
- C++ デッドロック調査 | C++那些事
- C++ SIMD ベクトル化 | C++那些事
- C++ False Sharing とキャッシュライン | C++那些事
- GDB マルチスレッド All-Stop デバッグ | C++那些事
- Helgrind 並行エラー検出 | C++那些事
- libev イベントループの原理 | C++那些事
- C++ std::thread の内部実装 | C++那些事
- C++ std::thread と jthread | C++那些事
- C++ マルチスレッド入門 | C++那些事