最終更新:2026-10-12
C++ string SSO パフォーマンステスト
今日は皆さんに2つの質問があります:
1.次のコードにパフォーマンス上の違いはあるか?
2.sizeof(std::string) はいくつか?
それでは、この2つの問題を一緒に探っていきましょう。
この2つの答えは g++(libstdc++)と clang(libc++)で結果が異なるため、ここではそれぞれ分析します。
1.g++(libstdc++)
g++ のソースコードは g++-10 を例にとります。詳細なコードはこの GitHub アドレスをご覧ください。ここでは核心的な部分だけを示します。
template<typename _CharT, typename _Traits, typename _Alloc>
class basic_string {
  private:
    struct _Alloc_hider : allocator_type {
        pointer _M_p; // The actual data.
    };
      enum { __min_cap = 15 / sizeof(value_type) };
    _Alloc_hider    _M_dataplus;             //  8 bytes
    size_type __size_;                     //  8 bytes

    union {
            _CharT           _M_local_buf[_S_local_capacity + 1]; // 16 bytes
            size_type        _M_allocated_capacity;                             // 8 bytes
    }; // 16 bytes
}; // 32 bytes
上のコードのコメント部分に、string が占めるバイト数が詳しく列挙されています(注意:ここでは value_type を char として計算しています。つまり sizeof(value_type) = 1 です)。
sizeof(string) = 8 + 8 + 16 = 32。
うち 8 バイトが ptr、8 バイトが size、16 バイトが union です。
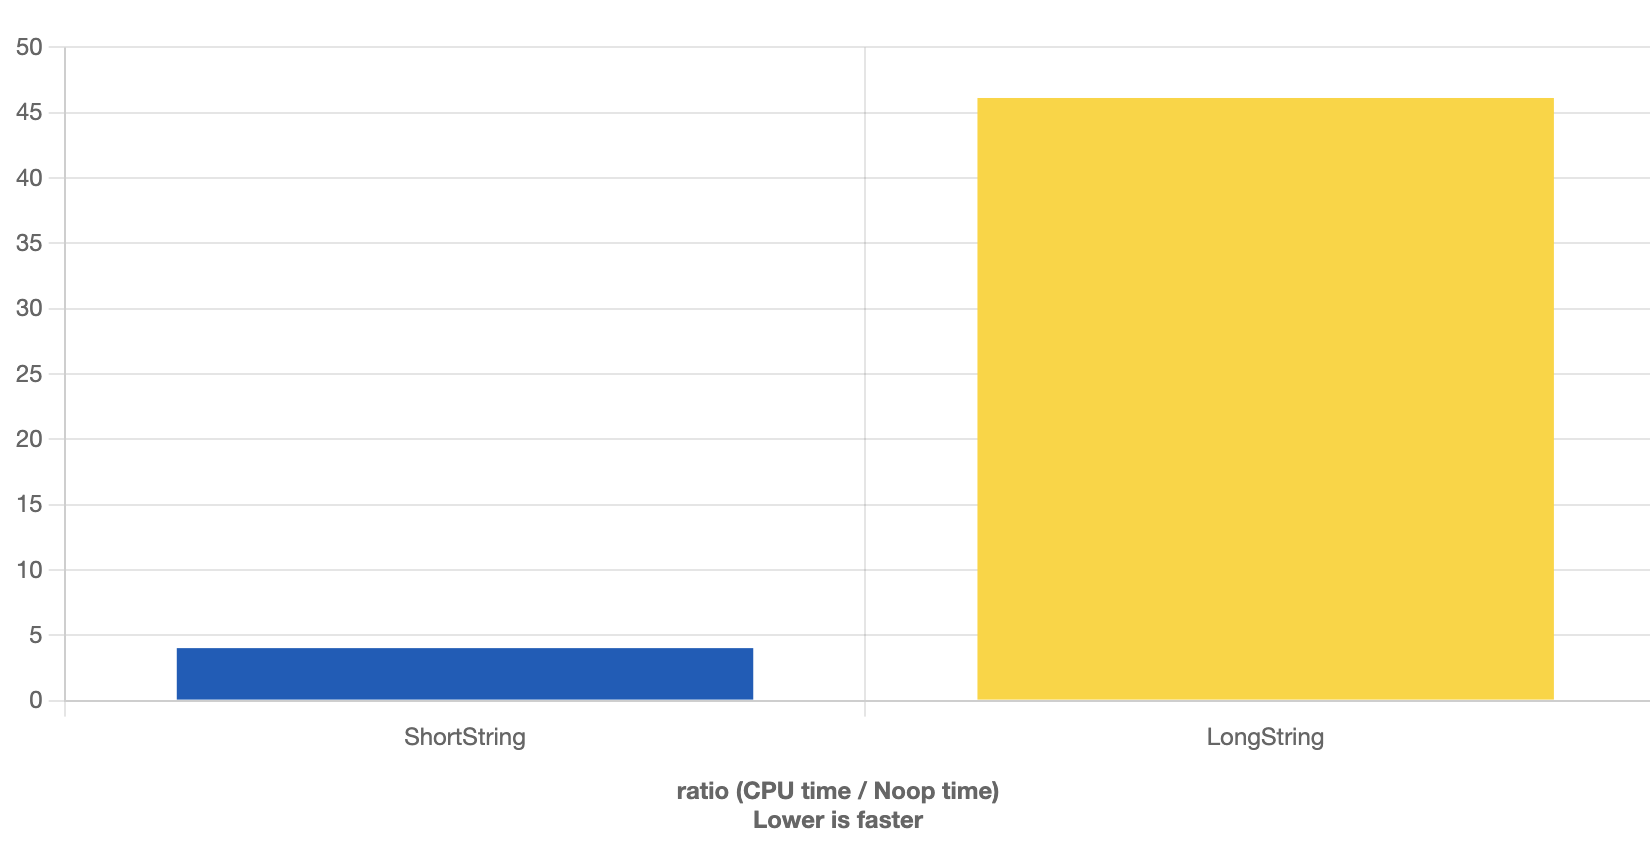
パフォーマンスの面では、ここでは SSO が実装されており、ローカルバッファは最大 15 文字まで格納し、15 文字を超えると heap 上に確保されます。ここで、パフォーマンスを比較する benchmark を書きました。
- 短い文字列のテスト内容:"hello world hel"、合計 15 文字。
- 長い文字列のテスト内容:"hello world helo"、合計 16 文字。
パフォーマンスの差が非常に大きいことがわかります。わずか1文字の違いで std::string のパフォーマンスがここまで変わるのです!
本質は前述の SSO ローカルバッファです。
パフォーマンステスト:https://quick-bench.com/q/s7pvDB_SwQyDCcZk50odAaYIzMc
2.clang++(libc++)
同様に llvm-14 を例にとります。完全なコードを見たい場合は下の GitHub アドレスをご覧ください。ここでは核心部分を抜粋します。
https://github.com/llvm/llvm-project/blob/release/14.x/libcxx/include/string#L765
template<class _CharT, class _Traits, class _Allocator>
class basic_string {
  private:
    struct __long {
        size_type __cap_;               // 8 bytes
        size_type __size_;              // 8 bytes
        pointer   __data_;              // 8 bytes
    };

        enum {__min_cap = (sizeof(__long) - 1)/sizeof(value_type) > 2 ?
                      (sizeof(__long) - 1)/sizeof(value_type) : 2};

    struct __short {
        union {
            unsigned char __size_;      // 1 bytes
            value_type __lx;            // 1 bytes
        };                              // 1 bytes
        value_type __data_[__min_cap];  // 23 bytes
    };                                  // 24 bytes

        union __ulx {
            __long __lx;        // 24 bytes
            __short __lxx;  // 24 bytes
        }; // 24 bytes
}
上のコードのコメント部分に、string が占めるバイト数が詳しく列挙されています(注意:ここでは value_type を char として計算しています。つまり sizeof(value_type) = 1 です)。
sizeof(string) = union のサイズで、この union は 24 バイトなので 24 になります。
SSO については、ローカルバッファに格納できる文字数は 22 文字までで、22 文字を超えると heap 上に確保されます。
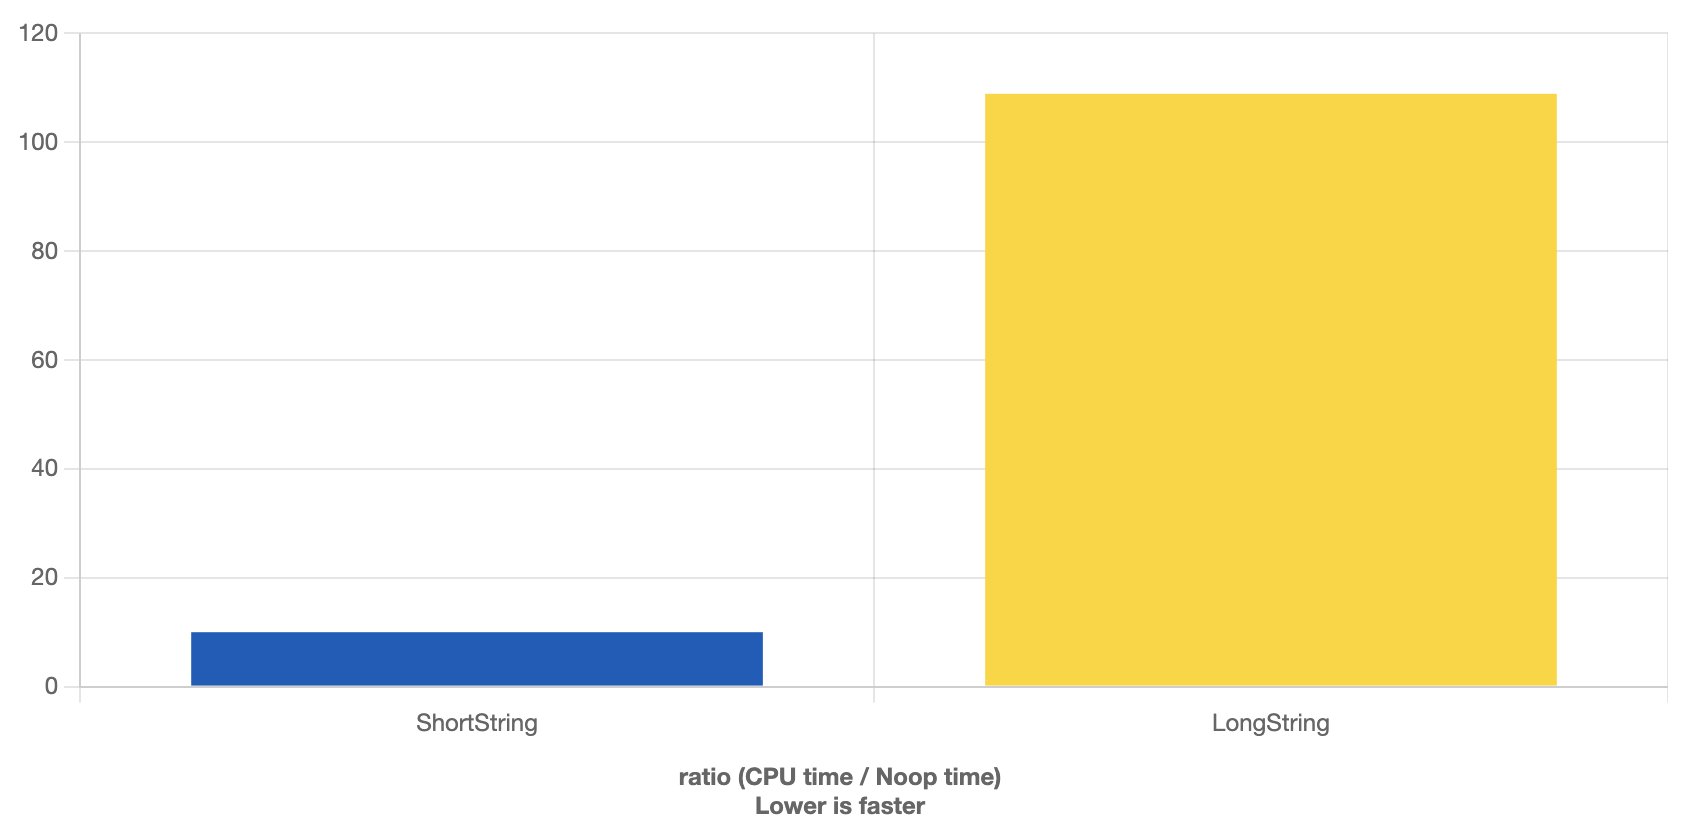
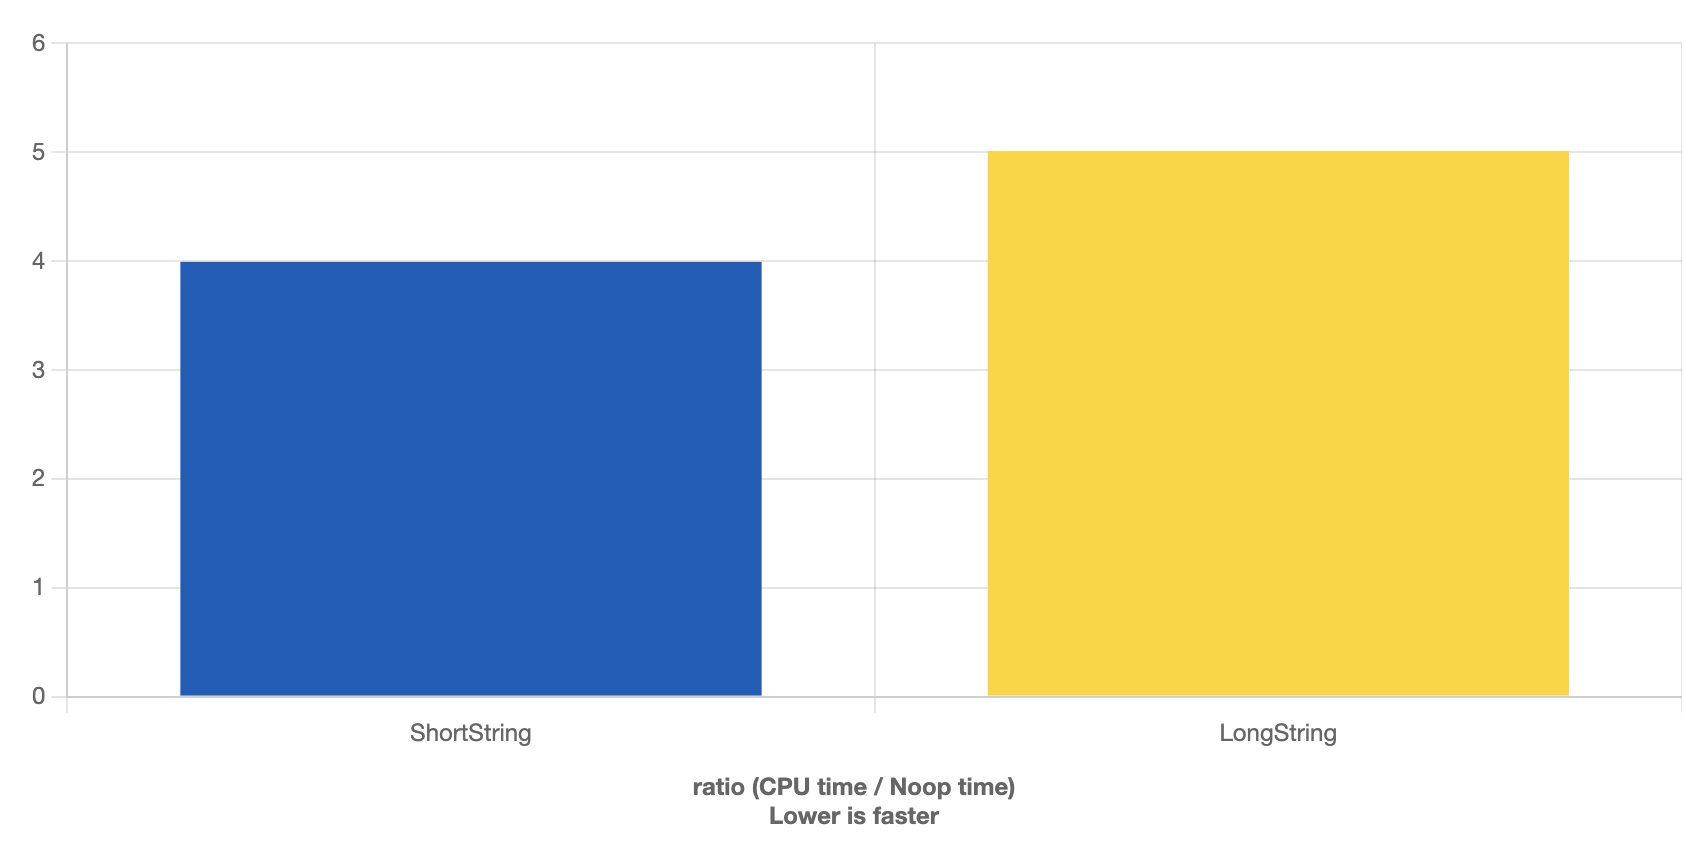
そのため、gcc と同じテストコードを clang に適用すると、少し違う結果が得られます。つまり、long 文字列と short 文字列のパフォーマンスの差が大きくありません。理由は、gcc のテストケースがどちらも 22 文字以内、つまりすべて短い文字列だったためです。
パフォーマンステスト:https://quick-bench.com/q/nmLMqQZ31cmWBbbIFr2nHN2JL1k
本当に長い文字列と短い文字列をテストすると、パフォーマンスは明確に変化し、傾向は gcc と一致します。
- 短い文字列のテスト内容:"hello world hello worl"、合計 22 文字。
- 長い文字列のテスト内容:"hello world hello world"、合計 23 文字。
パフォーマンステスト:https://quick-bench.com/q/ujtMrtotEi6RrpfMDJ1UcSLFIJE