Última actualización:2026-10-12
Prueba de rendimiento del SSO de string en C++
Hoy quiero plantearos dos preguntas:
1.¿Hay diferencia de rendimiento entre los códigos siguientes?
2.¿Cuánto es sizeof(std::string)?
A continuación, exploremos juntos estas dos preguntas.
Como las respuestas a ambas difieren entre g++ (libstdc++) y clang (libc++), las analizaremos por separado.
1.g++(libstdc++)
Para el código fuente de g++ tomamos como referencia g++-10; el código detallado puede consultarse en esta dirección de github; aquí se lista el código más relevante.
template<typename _CharT, typename _Traits, typename _Alloc>
class basic_string {
  private:
    struct _Alloc_hider : allocator_type {
        pointer _M_p; // The actual data.
    };
      enum { __min_cap = 15 / sizeof(value_type) };
    _Alloc_hider    _M_dataplus;             //  8 bytes
    size_type __size_;                     //  8 bytes

    union {
            _CharT           _M_local_buf[_S_local_capacity + 1]; // 16 bytes
            size_type        _M_allocated_capacity;                             // 8 bytes
    }; // 16 bytes
}; // 32 bytes
En los comentarios del código anterior se detalla cuántos bytes ocupa string (nota: aquí value_type se computa como char, es decir, sizeof(value_type) = 1).
sizeof(string) = 8 + 8 + 16 = 32.
Concretamente: 8 bytes de ptr, 8 bytes de size y 16 bytes de union.
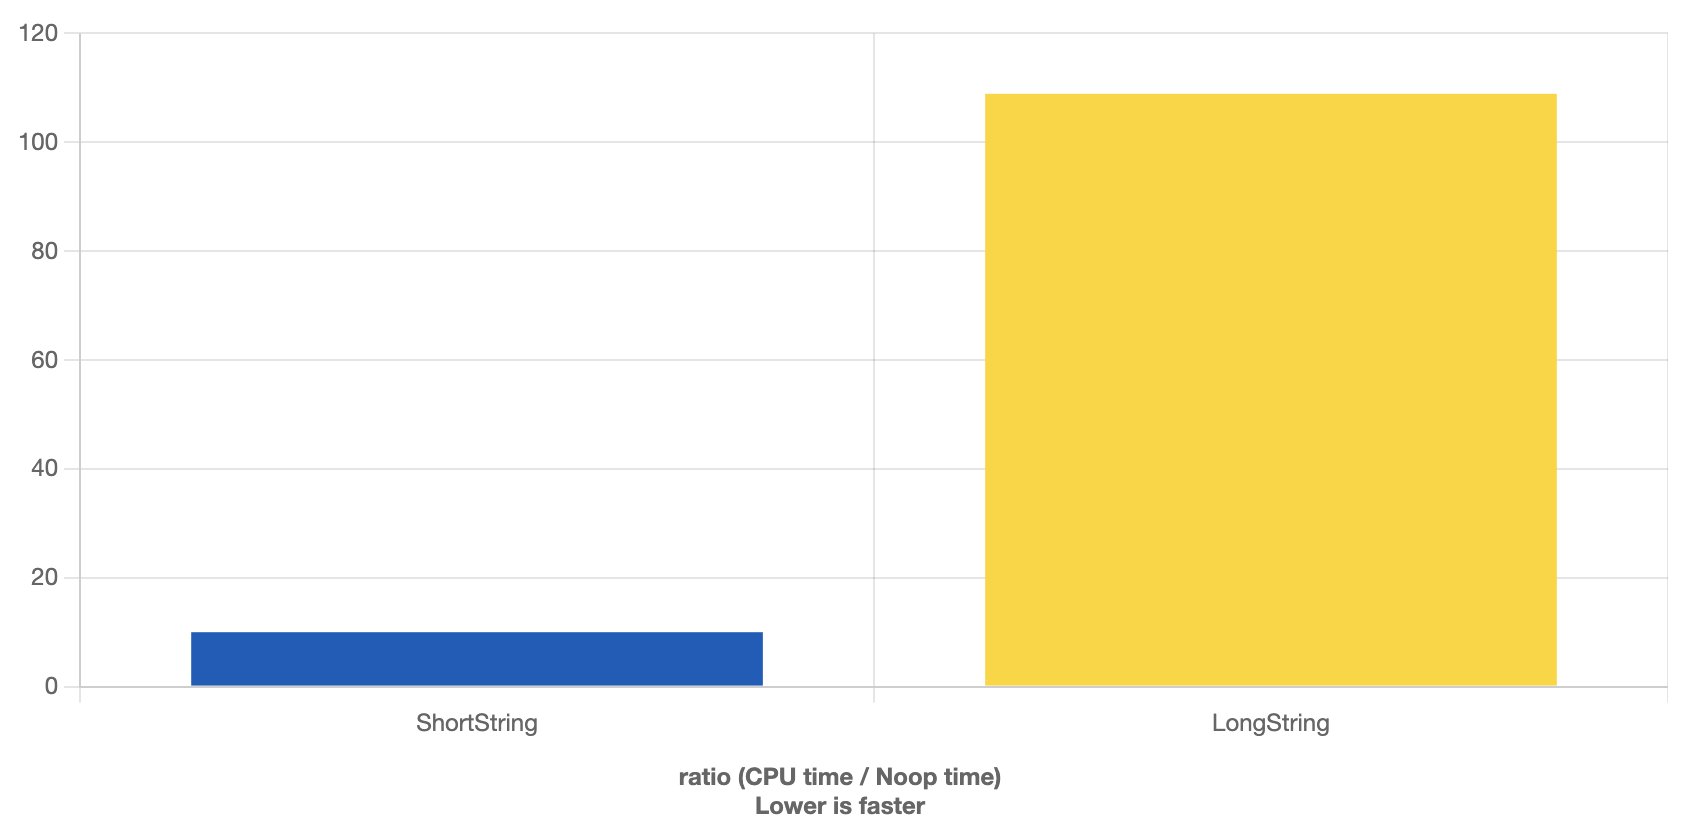
En el plano del rendimiento, aquí se implementa el SSO: el búfer local almacena hasta 15 caracteres; al superar los 15 caracteres, la asignación pasa al heap. He escrito un benchmark para comparar el rendimiento.
- El contenido de la prueba con cadena corta es: "hello world hel", 15 caracteres en total.
- El contenido de la prueba con cadena larga es: "hello world helo", 16 caracteres en total.
Puede verse que la diferencia de rendimiento es enorme: ¡un solo carácter provoca una variación de rendimiento tan grande en std::string!
En el fondo, esto se debe al SSO local buffer comentado antes.
Prueba de rendimiento: https://quick-bench.com/q/s7pvDB_SwQyDCcZk50odAaYIzMc
2.clang++(libc++)
De forma análoga, tomamos como referencia llvm-14; para ver el código completo, consulta la siguiente dirección de github; aquí se extrae el código esencial.
https://github.com/llvm/llvm-project/blob/release/14.x/libcxx/include/string#L765
template<class _CharT, class _Traits, class _Allocator>
class basic_string {
  private:
    struct __long {
        size_type __cap_;               // 8 bytes
        size_type __size_;              // 8 bytes
        pointer   __data_;              // 8 bytes
    };

        enum {__min_cap = (sizeof(__long) - 1)/sizeof(value_type) > 2 ?
                      (sizeof(__long) - 1)/sizeof(value_type) : 2};

    struct __short {
        union {
            unsigned char __size_;      // 1 bytes
            value_type __lx;            // 1 bytes
        };                              // 1 bytes
        value_type __data_[__min_cap];  // 23 bytes
    };                                  // 24 bytes

        union __ulx {
            __long __lx;        // 24 bytes
            __short __lxx;  // 24 bytes
        }; // 24 bytes
}
En los comentarios del código anterior se detalla cuántos bytes ocupa string (nota: aquí value_type se computa como char, es decir, sizeof(value_type) = 1).
sizeof(string) = el tamaño del union; este union ocupa 24 bytes, así que es igual a 24.
En cuanto al SSO, el búfer local almacena no más de 22 caracteres; al superar los 22 caracteres, la asignación pasa al heap.
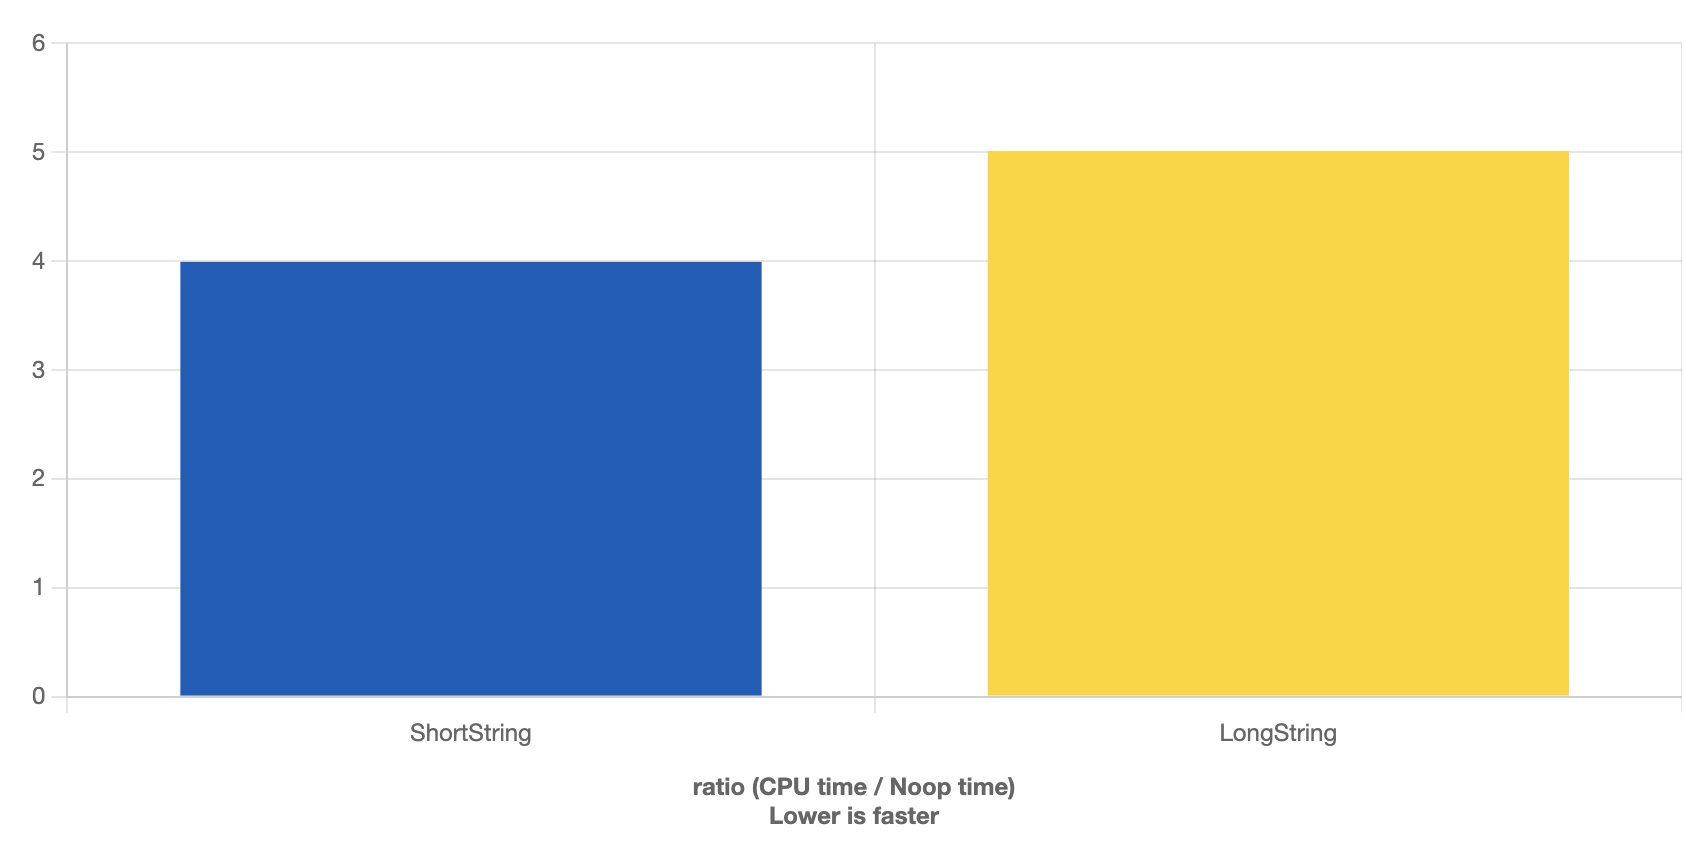
Por eso, al aplicar en clang el mismo código de prueba que en gcc, obtuvimos resultados bastante distintos: el rendimiento de la cadena long difiere poco del de la cadena short. La razón es que los casos de prueba de gcc estaban todos por debajo de 22 caracteres, todos eran cadenas cortas.
Prueba de rendimiento: https://quick-bench.com/q/nmLMqQZ31cmWBbbIFr2nHN2JL1k
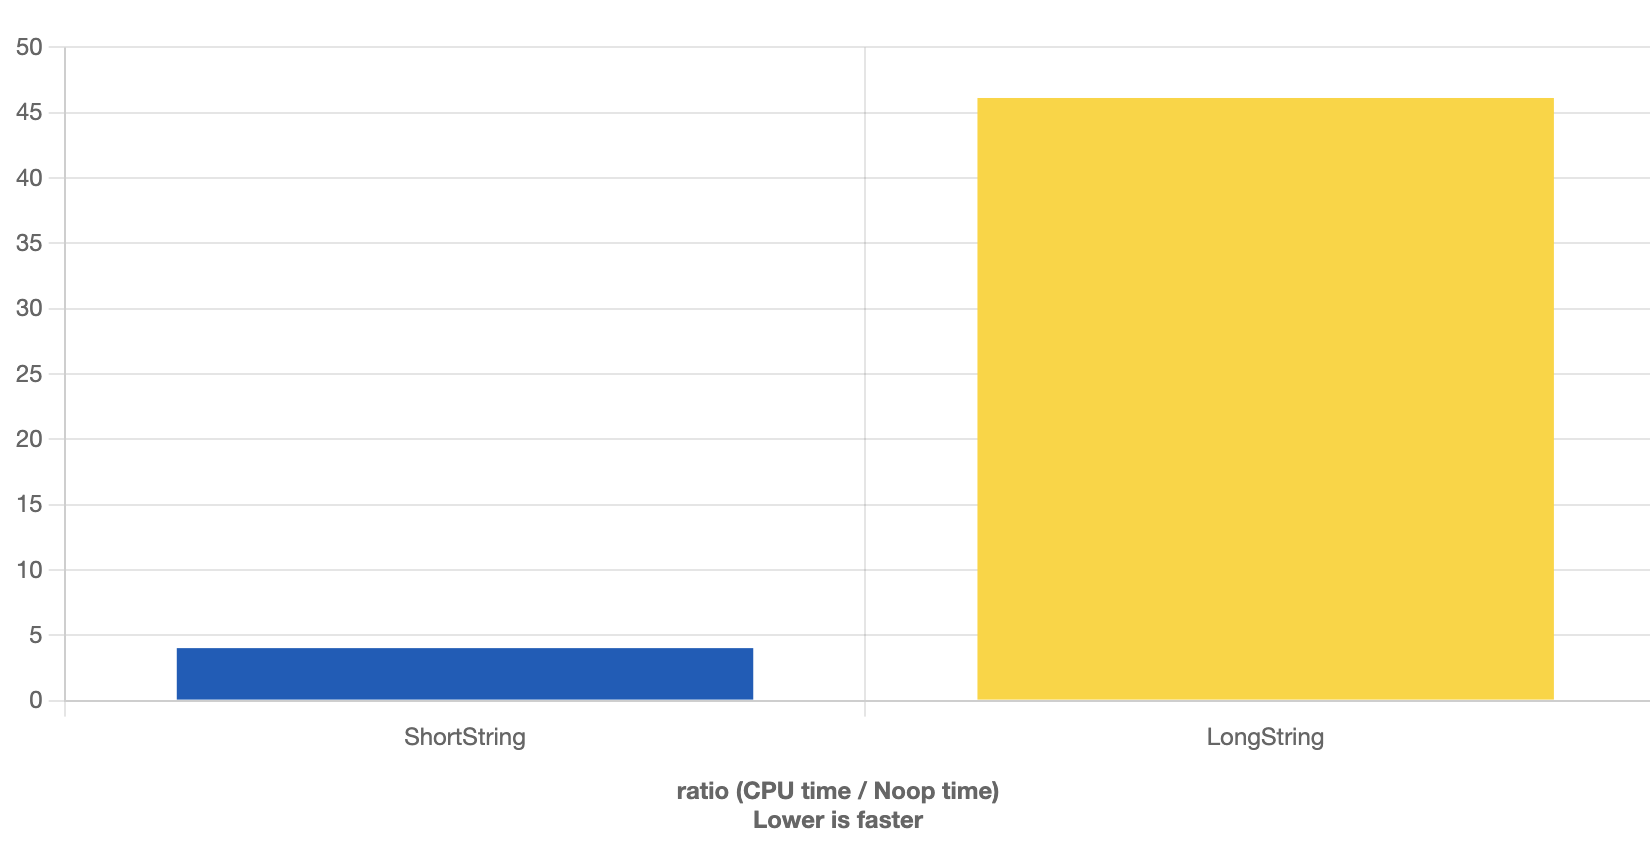
Cuando probamos cadenas realmente largas y cortas, el rendimiento cambia de forma notable, con una tendencia coincidente con gcc.
- El contenido de la prueba con cadena corta es: "hello world hello worl", 22 caracteres en total.
- El contenido de la prueba con cadena larga es: "hello world hello world", 23 caracteres en total.
Prueba de rendimiento: https://quick-bench.com/q/ujtMrtotEi6RrpfMDJ1UcSLFIJE
Temas relacionados
- Comparación de rendimiento: memcpy frente a std::copy | C++那些事
- Polimorfismo en C++: funciones virtuales, CRTP y variant | C++那些事