Última actualización:2026-10-12
Análisis del código fuente de STL list
0. Introducción
La versión del código fuente correspondiente es gcc-4.9.1
1.list
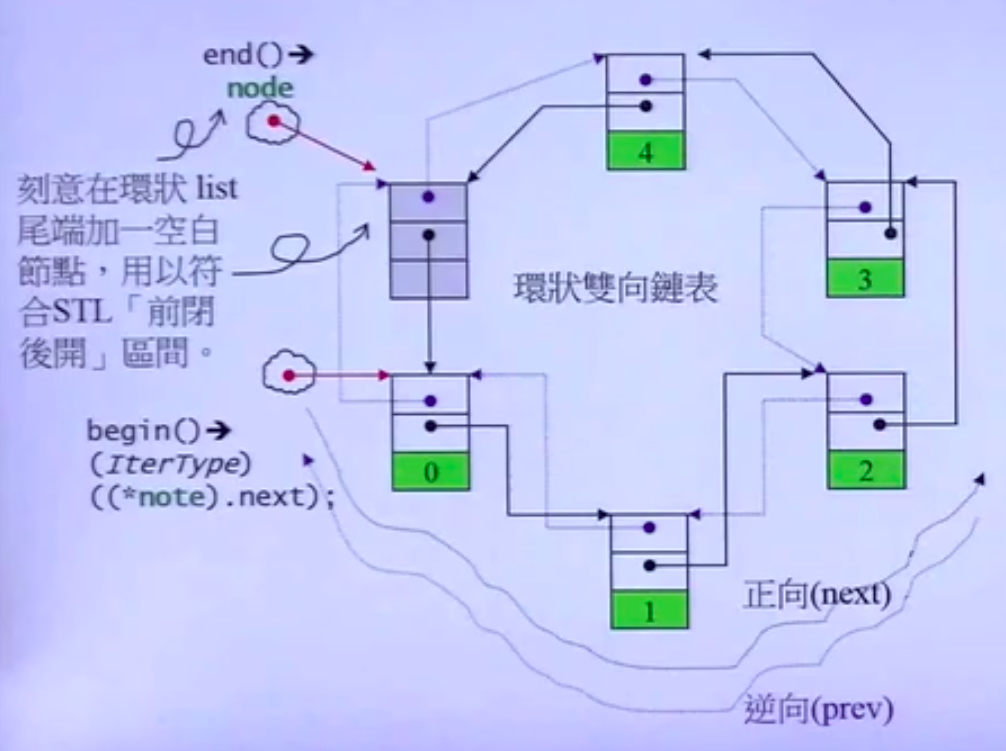
list es una lista enlazada circular bidireccional; su estructura es:
El diagrama que dibujé yo:
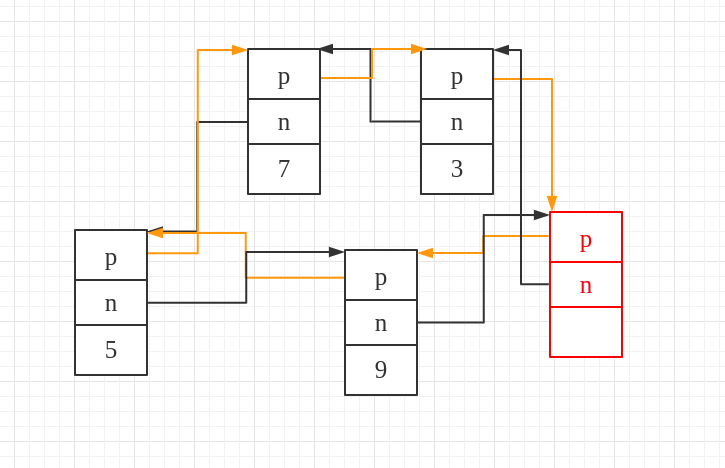
En la lista circular bidireccional se empieza insertando por el nodo con valor 3; el recuadro rojo representa el último nodo (el nodo al que apunta end()). Las líneas amarillas apuntan al nodo predecesor y las líneas negras al nodo sucesor.
1.1 Código fuente de list
1.1.1 Estructura de la clase
 template<typename _Tp, typename _Alloc = std::allocator<_Tp> >
 class list : protected _List_base<_Tp, _Alloc>
 {

 }
list hereda de _List_base.
1.1.2 Implementación de la lista circular bidireccional
【Constructor】
(1)list sin ningún elemento
(2)list con n elementos a los que se asigna un valor inicial
explicit list(size_type __n, const value_type &__value = value_type(),const allocator_type &__a = allocator_type()) : _Base(_Node_alloc_type(__a))
{ _M_fill_initialize(__n, __value); }
(3)Inicializar un list a partir de un rango
template<typename _InputIterator>
list(_InputIterator __first, _InputIterator __last,
     const allocator_type &__a = allocator_type())
        : _Base(_Node_alloc_type(__a)) {
    // Check whether it's an integral type.  If so, it's not an iterator.
    typedef typename std::__is_integer<_InputIterator>::__type _Integral;
    _M_initialize_dispatch(__first, __last, _Integral());
}
【Creación de nodos】
Lo que hace: crear un nodo nuevo y asignar memoria dinámicamente, devolviendo el nodo.
_Node *_M_create_node(const value_type &__x) {
    _Node *__p = this->_M_get_node();
    __try
    {
        _M_get_Tp_allocator().construct
                (std::__addressof(__p->_M_data), __x);
    }
    __catch(...)
    {
        _M_put_node(__p);
        __throw_exception_again;
    }
    return __p;
}
Obsérvese que dentro hay dos funciones importantes, _M_get_node y _M_put_node; al consultarlas descubrimos que estos métodos provienen de la clase base, cuyo código fuente es:
_List_node<_Tp> * _M_get_node() { return _M_impl._Node_alloc_type::allocate(1); }

void _M_put_node(_List_node<_Tp> *__p)   _GLIBCXX_NOEXCEPT
{ _M_impl._Node_alloc_type::deallocate(__p, 1); }
Se corresponden con la asignación dinámica de memoria al crear el nodo y, si se lanza una excepción durante la creación, la liberación de la memoria.
【Inserción de nodos】
La inserción de nodos incluye:
- Insertar al final n nodos con el valor de nodo especificado; la función correspondiente es
_M_fill_initialize
Se usa en el constructor de list:
explicit list(size_type __n, const value_type &__value = value_type(),const allocator_type &__a = allocator_type()) : _Base(_Node_alloc_type(__a))
{ _M_fill_initialize(__n, __value); }
- Insertar un nodo con el valor de nodo especificado en la posición indicada; la función correspondiente es
_M_insert
Los tan usados push_back y push_front invocan en la capa inferior la función _M_insert.
La diferencia entre ambas funciones es:
- Función de inserción de la lista circular bidireccional
_M_hook(¡¡¡la más importante!!!)
Funciones como las mencionadas antes push_back, push_front, _M_insert y también insert se implementan todas con la función de inserción básica de lista bidireccional _M_hook.
Veámoslo en profundidad:
El código fuente de _M_fill_initialize es el siguiente:
void _M_fill_initialize(size_type __n, const value_type &__x) {
    for (; __n; --__n)
        push_back(__x);
}
El código fuente de push_back es el siguiente:
_M_insert inserta, en la posición indicada, un nodo con valor inicial x.
void _M_insert(iterator __position, const value_type &__x) {
    _Node *__tmp = _M_create_node(__x);
    __tmp->_M_hook(__position._M_node);
}
La implementación de _M_hook está en gcc-4.9.1/libstdc++-v3/src/c++98/list.cc; por supuesto, las demás funciones de _List_node_base, por ejemplo _M_unhook, también están en ese archivo.
// 在指定的位置前插入this指向的节点
void_List_node_base::_M_hook(_List_node_base* const __position) _GLIBCXX_USE_NOEXCEPT
{
  this->_M_next = __position;
  this->_M_prev = __position->_M_prev;
  __position->_M_prev->_M_next = this;
  __position->_M_prev = this;
}
Así que lo anterior se descompone en dos funciones. Resumamos el código anterior:
(1)Insertar en la posición indicada un nodo con valor inicial x
void _M_insert(iterator __position, const value_type &__x) {
    _Node *__tmp = _M_create_node(__x);
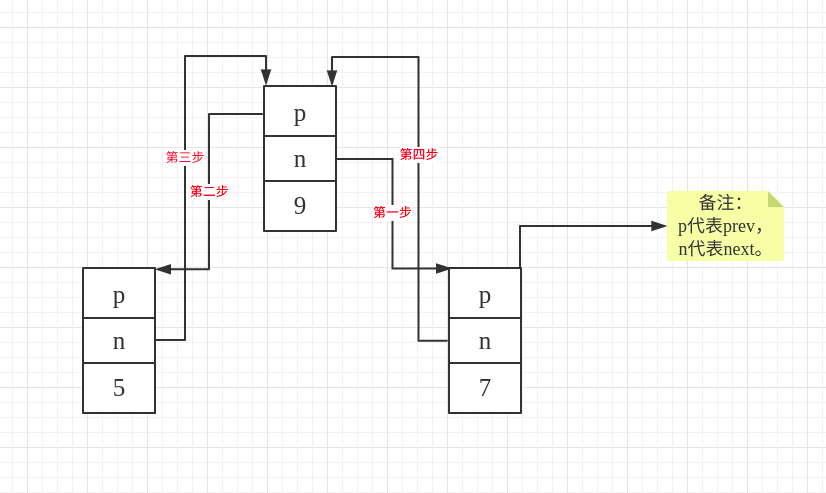
    __tmp->_M_next = __position;            // 第一步
    __tmp->_M_prev = __position->_M_prev;   // 第二步
    __position->_M_prev->_M_next = __tmp;   // 第三步
    __position->_M_prev = __tmp;            // 第四步
}
Esta inserción se hace antes de la posición indicada; (llevado al código) por ejemplo, insertar antes del nodo especificado __position de valor 7 un nodo de valor 9 (que en el código es __tmp); a continuación se explica el flujo concreto de la inserción.
(2)Insertar al final, una a una, n nodos con valor de nodo x
void _M_fill_initialize(size_type __n, const value_type &__x) {
    for (; __n; --__n)
        _M_insert(end(), __x);
}
Este código recordará a insert, que tiene tres versiones. El archivo de implementación de insert está en libstdc++-v3/include/bits/list.tcc.
- Primera: insertar antes del iterador especificado un nodo con el valor de elemento indicado.
La implementación invoca la función _M_hook anterior.
template<typename _Tp, typename _Alloc>
typename list<_Tp, _Alloc>::iterator
list<_Tp, _Alloc>::
#if __cplusplus >= 201103L
insert(const_iterator __position, const value_type& __x)
#else
insert(iterator __position, const value_type& __x)
#endif
{
  _Node* __tmp = _M_create_node(__x);
  __tmp->_M_hook(__position._M_const_cast()._M_node);
  return iterator(__tmp);
}
- Segunda: insertar antes del iterador especificado n nodos con el valor de nodo indicado.
La implementación llama primero al constructor de list, creando un list con n nodos del valor indicado.
explicit list(size_type __n, const value_type &__value = value_type(),const allocator_type &__a = allocator_type()) : _Base(_Node_alloc_type(__a))
{ _M_fill_initialize(__n, __value); }
Después usa la función splice para insertar en el list actual a partir de otro list.
void splice(iterator __position, list &__x)
{
    if (!__x.empty()) {
        _M_check_equal_allocators(__x);

        this->_M_transfer(__position._M_const_cast(),
                          __x.begin(), __x.end());
    }
}
Siguiendo el rastro del código de _M_transfer, se puede saber:
// Moves the elements from [first,last) before position.
void
_M_transfer(iterator __position, iterator __first, iterator __last) {
    __position._M_node->_M_transfer(__first._M_node, __last._M_node);
}
Analizando de nuevo, se descubre que proviene de la clase base de list, _List_node_base, y el archivo de implementación de _M_transfer está en gcc-4.9.1/libstdc++-v3/src/c++98/list.cc:
void _List_node_base::
_M_transfer(_List_node_base * const __first,
    _List_node_base * const __last) _GLIBCXX_USE_NOEXCEPT
{
  if (this != __last)
  {
      // Remove [first, last) from its old position.
      __last->_M_prev->_M_next  = this;
      __first->_M_prev->_M_next = __last;
      this->_M_prev->_M_next    = __first;

      // Splice [first, last) into its new position.
      _List_node_base* const __tmp = this->_M_prev;
      this->_M_prev                = __last->_M_prev;
      __last->_M_prev              = __first->_M_prev;
      __first->_M_prev             = __tmp;
  }
}
Volvemos al diagrama anterior:
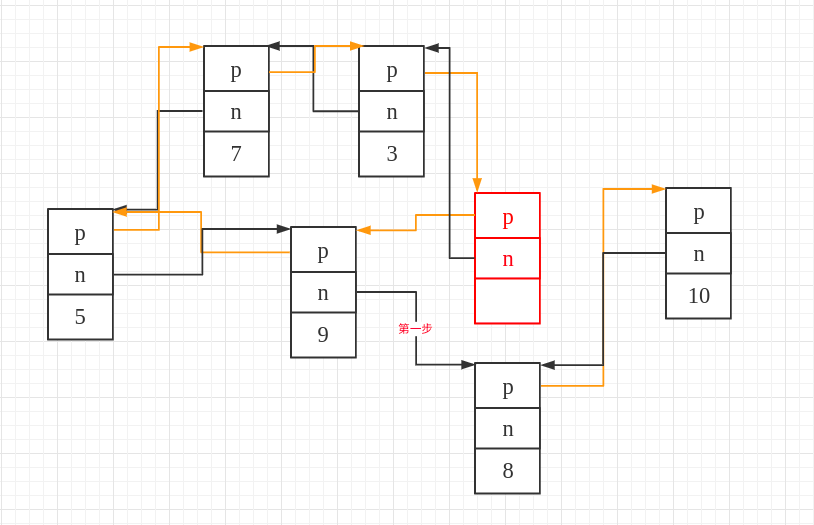
Tras el análisis anterior, sabemos que splice inserta el list completo representado por el diagrama anterior delante del iterador especificado; por ejemplo, si queremos insertar delante de los dos nodos siguientes, los pasos gráficos concretos son:
El nodo representado por this es el nodo de valor 8; el siguiente diagrama describe la inserción del list completo entre el nodo 10 y el nodo 8.
__last representa el nodo del recuadro rojo, que es el nodo al que apunta end(); no necesitamos ese nodo, así que en el procesamiento posterior se elimina del list completo.
__first representa el nodo de valor 3 del diagrama.
Primer paso: hacer que el siguiente puntero del último nodo válido, es decir, el nodo anterior al recuadro rojo, apunte al nodo 8 indicado.
El código correspondiente es:
Segundo paso: el puntero next de _last apunta a sí mismo.

El código correspondiente es:
Tercer paso: hacer que el next del nodo anterior al iterador especificado apunte al primer nodo del list original (__first).
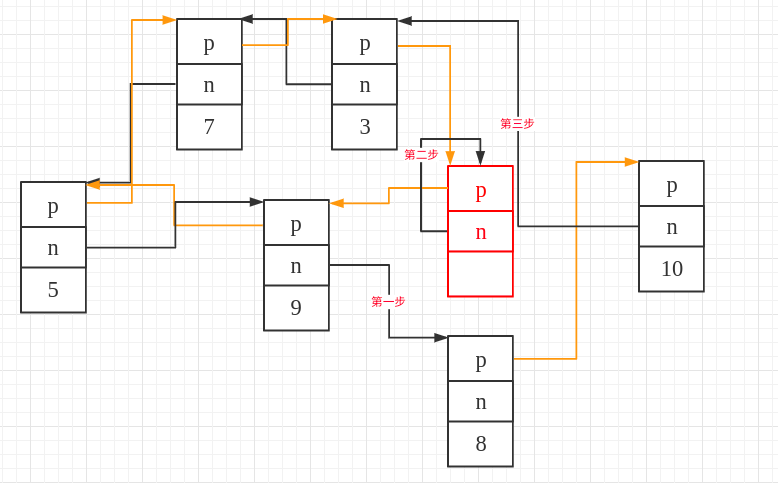
El código correspondiente es:
Cuarto paso: guardar el nodo predecesor del iterador especificado (que en el diagrama se corresponde con el nodo de valor 10).
Quinto paso: el nodo predecesor del iterador especificado apunta al último nodo real del list original (el nodo anterior a end()).
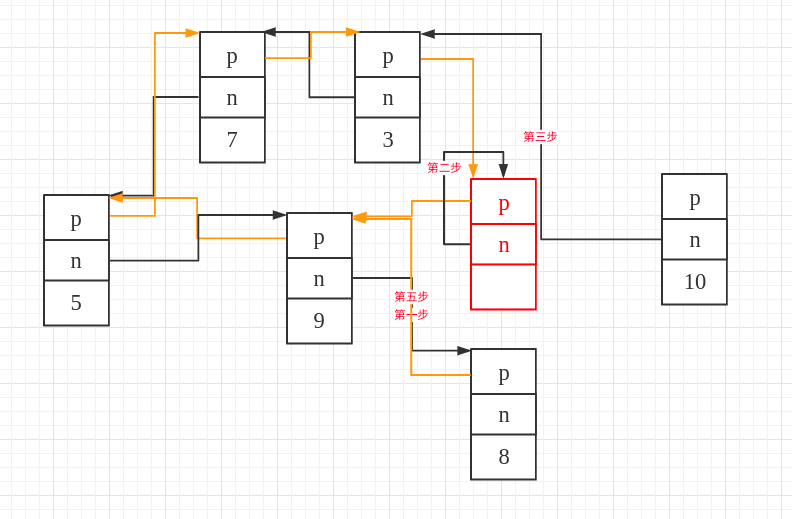
El código correspondiente es:
Sexto paso: hacer que el prev del último nodo del list original (el nodo al que apunta end()) apunte a sí mismo.

El código correspondiente es:
Séptimo paso: hacer que el prev del primer nodo del list original apunte al nodo guardado en el cuarto paso.
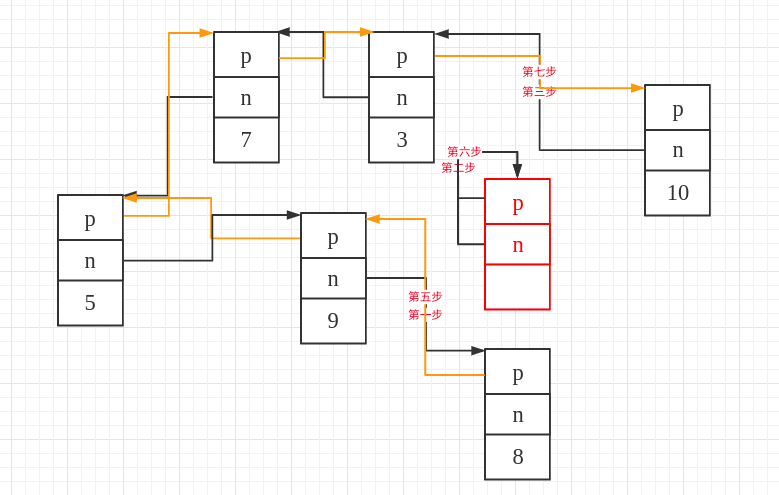
El código correspondiente es:
Así, tras estas siete operaciones, se completa la inserción de un list entre el nodo 8 y el nodo 10.
- Tercera: insertar los datos de un rango de un list delante del iterador especificado.
El principio es el mismo; lo único que cambia es que este __tmp invoca a otro constructor.
【Borrado de nodos】
- Borrar el nodo especificado
El borrado del nodo especificado se divide en dos: el primero borra mediante iterador, el segundo mediante el valor del elemento.
(1)Borrado mediante iterador; la función correspondiente es erase
pop_front, pop_back, erase y remove se implementan en la capa inferior sobre la función _M_erase.
this->_M_erase(begin());    // pop_front 不断删除起点的元素
this->_M_erase(iterator(this->_M_impl._M_node._M_prev)); // pop_back移除最后一个元素
En libstdc++-v3/include/bits/list.tcc:
erase(iterator __position)
#endif
{
  iterator __ret = iterator(__position._M_node->_M_next);
  _M_erase(__position._M_const_cast());
  return __ret;
}
(2)Borrado mediante el valor del elemento; la función correspondiente es remove
Tratamiento del caso especial: cuando la dirección del elemento a borrar coincide con la dirección del iterador, primero se guarda y, al final, se comprueba si el iterador guardado es end(); si no lo es, se borra. En la capa inferior se sigue borrando con _M_erase.
template<typename _Tp, typename _Alloc>
void list<_Tp, _Alloc>::remove(const value_type& __value)
{
  iterator __first = begin();
  iterator __last = end();
  iterator __extra = __last;
  while (__first != __last)
  {
      iterator __next = __first;
      ++__next;
      if (*__first == __value)
        {
          // _GLIBCXX_RESOLVE_LIB_DEFECTS
          // 526. Is it undefined if a function in the standard changes
          // in parameters?
          if (std::__addressof(*__first) != std::__addressof(__value))
        _M_erase(__first);
          else
        __extra = __first;
        }
      __first = __next;
  }
  if (__extra != __last)
    _M_erase(__extra);
}
Además de este remove, hay otro, remove_if, que borra según una condición.
template<typename _Tp, typename _Alloc>
template <typename _Predicate>
void list<_Tp, _Alloc>::
remove_if(_Predicate __pred)
{
    iterator __first = begin();
    iterator __last = end();
    while (__first != __last)
    {
        iterator __next = __first;
        ++__next;
        if (__pred(*__first))
          _M_erase(__first);
        __first = __next;
    }
}
Basta con quitar el if del remove anterior y añadir dentro una comprobación.
Se usa así:
bool isone(int one) {
    return one==2;
}
int main() {
    list<int> t;
    t={3,4,0,2,0,10,10};
    for(auto i:t) cout<<i<<" ";  // 3 4 0 2 0 10 10
    cout<<endl;
    t.remove_if(isone);
    for(auto i:t) cout<<i<<" ";  // 3 4 0 0 10 10
    cout<<endl;
}
- Borrar una serie de nodos
- Borrar todos los nodos; la función correspondiente es
clear
(1)Análisis detallado del borrado del nodo especificado
_M_erase(iterator __position)
_GLIBCXX_NOEXCEPT
{
    __position._M_node->_M_unhook();
    _Node *__n = static_cast<_Node *>(__position._M_node);
#if __cplusplus >= 201103L
    _M_get_Node_allocator().destroy(__n);
#else
    _M_get_Tp_allocator().destroy(std::__addressof(__n->_M_data));
#endif
    _M_put_node(__n);       // 释放内存
}
La implementación de _M_unhook está en gcc-4.9.1/libstdc++-v3/src/c++98/list.cc; su implementación es la siguiente:
void _List_node_base::_M_unhook() _GLIBCXX_USE_NOEXCEPT
{
  _List_node_base* const __next_node = this->_M_next;   // 第一步:保存后继节点
  _List_node_base* const __prev_node = this->_M_prev;   // 第二步:保存前驱节点
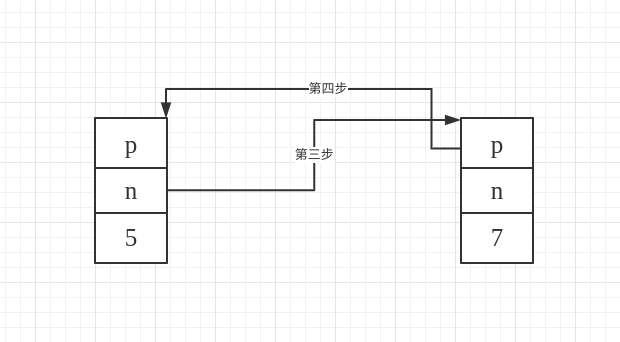
  __prev_node->_M_next = __next_node;                   // 第三步:前驱节点的next指向后继节点
  __next_node->_M_prev = __prev_node;                   // 第四步:后继节点的prev指向前驱节点
}
Por ejemplo: borrar el nodo de valor 9; ilustración de los pasos tercero y cuarto:
(2)Análisis detallado del borrado de una serie de elementos
iterator
#if __cplusplus >= 201103L
erase(const_iterator __first, const_iterator __last) noexcept
#else
erase(iterator __first, iterator __last)
#endif
{
    while (__first != __last)
        __first = erase(__first);
    return __last._M_const_cast();
}
Usando erase, se borran los datos del rango de iteradores dado.
(3)Análisis detallado del borrado de todos los elementos
Vacía los elementos y reinicializa, volviendo al estado por defecto del list.
La implementación de _M_clear está en libstdc++-v3/include/bits/list.tcc:
_List_base<_Tp, _Alloc>::
_M_clear() _GLIBCXX_NOEXCEPT
{
  typedef _List_node<_Tp>  _Node;
  _Node* __cur = static_cast<_Node*>(_M_impl._M_node._M_next);
  while (__cur != &_M_impl._M_node)
    {
      _Node* __tmp = __cur;         // 保存节点
      __cur = static_cast<_Node*>(__cur->_M_next);  // 往后遍历
    #if __cplusplus >= 201103L
      _M_get_Node_allocator().destroy(__tmp);
    #else
      _M_get_Tp_allocator().destroy(std::__addressof(__tmp->_M_data));
    #endif
      _M_put_node(__tmp);   // 释放内存
    }
}
La implementación de _M_init: basta con que todo apunte a sí mismo.
void _M_init()
_GLIBCXX_NOEXCEPT
{
    this->_M_impl._M_node._M_next = &this->_M_impl._M_node;
    this->_M_impl._M_node._M_prev = &this->_M_impl._M_node;
}
【Acceso a elementos】
Cada uno implementa dos versiones: referencia y referencia constante.
-
front devuelve el primer elemento
-
Devolver el último elemento
【Algoritmos】
- unique
Elimina de cada grupo consecutivo de elementos iguales del contenedor todos los elementos salvo el primero.
Ten en cuenta que un elemento solo se elimina del contenedor lista si es igual al elemento inmediatamente anterior del contenedor lista. Por eso, esta función resulta especialmente útil para listas ordenadas.
template<typename _Tp, typename _Alloc>
template <typename _BinaryPredicate>
  void
  list<_Tp, _Alloc>::
  unique(_BinaryPredicate __binary_pred)
  {
    iterator __first = begin();
    iterator __last = end();
    if (__first == __last)
  return;
    iterator __next = __first;
    while (++__next != __last)
  {
    // 满足条件就删除
    if (__binary_pred(*__first, *__next))
       // 删除
      _M_erase(__next);
    else
      __first = __next;
    __next = __first;
  }
  }
Un ejemplo:
// list::unique
#include <iostream>
#include <cmath>
#include <list>

// a binary predicate implemented as a function:
bool same_integral_part (double first, double second)
{ return ( int(first)==int(second) ); }

// a binary predicate implemented as a class:
struct is_near {
  bool operator() (double first, double second)
  { return (fabs(first-second)<5.0); }
};

int main ()
{
  double mydoubles[]={ 12.15,  2.72, 73.0,  12.77,  3.14,
                       12.77, 73.35, 72.25, 15.3,  72.25 };
  std::list<double> mylist (mydoubles,mydoubles+10);

  mylist.sort();             //  2.72,  3.14, 12.15, 12.77, 12.77,
                             // 15.3,  72.25, 72.25, 73.0,  73.35

  mylist.unique();           //  2.72,  3.14, 12.15, 12.77
                             // 15.3,  72.25, 73.0,  73.35

  mylist.unique (same_integral_part);  //  2.72,  3.14, 12.15
                                       // 15.3,  72.25, 73.0

  mylist.unique (is_near());           //  2.72, 12.15, 72.25

  std::cout << "mylist contains:";
  for (std::list<double>::iterator it=mylist.begin(); it!=mylist.end(); ++it)
    std::cout << ' ' << *it;
  std::cout << '\n';

  return 0;
}
Lo anterior, tras ordenar, borra todos los elementos duplicados dejando solo uno; sin ordenar, solo borra los elementos duplicados y consecutivos.
- merge
La implementación del código fuente de merge usa la función _M_transfer anterior. Supongamos que hay dos list, list1 y list2. Se compara cada elemento de list1 con cada elemento de list2: si el elemento de list1 es menor que el de list2, se hace ++ en el iterador de list1 sin ninguna otra operación; si el elemento de list1 es mayor que el de list2, entonces en cada iteración se pasa a _M_transfer el iterador correspondiente al elemento menor de list2, y mediante esa función se inserta ese elemento menor de list2 delante del iterador de list1 recién comparado; así, al final todos los elementos acaban insertados en list1.
Cuando list1 ya se ha recorrido por completo y list2 todavía no, basta con ejecutar una vez _M_transfer, insertando en el final de list1 la lista list2 desde el iterador actual hasta su end.
template<typename _Tp, typename _Alloc>
void
list<_Tp, _Alloc>::
#if __cplusplus >= 201103L
merge(list&& __x)
#else
merge(list& __x)
#endif
{
  // _GLIBCXX_RESOLVE_LIB_DEFECTS
  // 300. list::merge() specification incomplete
  if (this != &__x)
  {
      _M_check_equal_allocators(__x);

      iterator __first1 = begin();
      iterator __last1 = end();
      iterator __first2 = __x.begin();
      iterator __last2 = __x.end();
      while (__first1 != __last1 && __first2 != __last2)
        if (*__first2 < *__first1)
         {
            iterator __next = __first2;
            _M_transfer(__first1, __first2, ++__next);
            __first2 = __next;
         }
        else
          ++__first1;
      if (__first2 != __last2)
        _M_transfer(__last1, __first2, __last2);
   }
}
Uso:
int main() {
    list<int> l1 = {2,3,5,7};
    list<int> l2 = {1,10,9,5};
    l1.sort();
    l2.sort();
    l1.merge(l2);
    for(auto i:l1) cout<<i<<" ";    // 1 2 3 5 5 7 9 10
    return 0;
}
- sort
Como el algoritmo de ordenación sort de STL exige iteradores de acceso aleatorio, mientras que el acceso del contenedor de lista bidireccional se hace con iteradores bidireccionales, no se puede usar el sort de STL: hay que definir un algoritmo de ordenación propio para su forma de acceso. Del análisis del código fuente se deduce que la idea de este algoritmo es similar a la ordenación por mezcla (merge sort).
El splice llamado dentro de sort es:
void splice(const_iterator __position, list& __x, const_iterator __i) noexcept
{ splice(__position, std::move(__x), __i); }
Análisis más detallado:
void
splice(iterator __position, list &__x, iterator __i)
{
    iterator __j = __i._M_const_cast();
    ++__j;
    if (__position == __i || __position == __j)
        return;

    if (this != &__x)
        _M_check_equal_allocators(__x);

    this->(__position._M_const_cast(),
                      __i._M_const_cast(), __j);
}
Lo que finalmente se invoca es _M_transfer.
En sort hay también una función swap, que intercambia dos listas; el código de implementación está en gcc-4.9.1/libstdc++-v3/src/c++98/list.cc:
void
_List_node_base::swap(_List_node_base& __x,
          _List_node_base& __y) _GLIBCXX_USE_NOEXCEPT
{
      if ( __x._M_next != &__x )
    {
      if ( __y._M_next != &__y )
        {
          // Both __x and __y are not empty.
          std::swap(__x._M_next,__y._M_next);
          std::swap(__x._M_prev,__y._M_prev);
          __x._M_next->_M_prev = __x._M_prev->_M_next = &__x;
          __y._M_next->_M_prev = __y._M_prev->_M_next = &__y;
        }
      else
        {
              // __x is not empty, __y is empty.
              __y._M_next = __x._M_next;
              __y._M_prev = __x._M_prev;
              __y._M_next->_M_prev = __y._M_prev->_M_next = &__y;
              __x._M_next = __x._M_prev = &__x;
            }
        }
      else if ( __y._M_next != &__y )
        {
          // __x is empty, __y is not empty.
          __x._M_next = __y._M_next;
          __x._M_prev = __y._M_prev;
          __x._M_next->_M_prev = __x._M_prev->_M_next = &__x;
          __y._M_next = __y._M_prev = &__y;
        }
}
La idea concreta de la implementación es comprobar si las dos listas están vacías o no y, a continuación, modificar los punteros next y prev.
Veamos ahora el potente sort:
template<typename _Tp, typename _Alloc>
void
list<_Tp, _Alloc>::
sort() {
    // Do nothing if the list has length 0 or 1.
    if (this->_M_impl._M_node._M_next != &this->_M_impl._M_node
        && this->_M_impl._M_node._M_next->_M_next != &this->_M_impl._M_node) {
        list __carry; // 辅助链表,用于从a中提取元素以及临时保存两个链表的合并结果
        list __tmp[64]; // 保存着当前每一个归并层次的结果, i号链表保存的元素个数为2的i次方或者0
        list *__fill = &__tmp[0]; // 表示当前最大归并排序的层次,while循环之后__fill变成log2(list.size())
        list *__counter;

        do {
            __carry.splice(__carry.begin(), *this, begin()); //把当前链表的第一个节点放在carry链表头

            for (__counter = &__tmp[0];
                 __counter != __fill && !__counter->empty();
                 ++__counter) {
                __counter->merge(__carry);  // 两个有序链表合并
                __carry.swap(*__counter); // 类似于交换链表carry和counter[i]内容
            }
            __carry.swap(*__counter); // 类似于交换链表carry和counter[i]内容
            if (__counter == __fill)
                ++__fill;
        } while (!empty());
        // 每两个进行归并,依次网上,直到最后*(__fill-1)保存最后的排序结果。然后交换到当前list中。
        for (__counter = &__tmp[1]; __counter != __fill; ++__counter)
            __counter->merge(*(__counter - 1));
        swap(*(__fill - 1));
    }
}
El código anterior resulta bastante difícil de entender; tras buscarlo en internet, en G2.9:
template <class T, class Alloc>
void list<T, Alloc> :: sort(){
    // 判断链表是否为空或者只有一个元素
    if(node->next == node || link_type(node->next)->next == node){
        return;
    }

    list<T, Alloc> carry;
    list<T, alloc> counter[64];
    int fill = 0;
    while(!empty()){
        carry.splice(carry.begin(), *this, begin());
        int i = 0;
        while(i < fill && !counter[i].empty()){
            counter[i].merge(carry);
            carry.swap(counter[i++]);
        }
        carry.swap(counter[i]);
        if(i == fill){
            ++fill;
        }
    }

    for(int i = 1; i < fill; ++i){
        counter[i].merge(counter[i-1]);
    }
    swap(counter[fill-1]);
}
La implementación externa correspondiente es:
void sortList(list<int> &l) {
    if (l.size() <= 1) {
        return;
    }
    list<int> carry;       // 辅助链表,用于从a中提取元素以及临时保存两个链表的合并结果
    list<int> counter[64]; // 保存着当前每一个归并层次的结果, i号链表保存的元素个数为2的i次方或者0
    int fill = 0;          // 表示当前最大归并排序的层次,while循环之后fill变成log2(a.size())

    while (!l.empty()) {
        carry.splice(carry.begin(), l, l.begin()); // 将链表a中的第一个元素移动至carry开头
        int i = 0;
        // 从小往大不断合并非空归并层次直至遇到空层或者到达当前最大归并层次
        while (i < fill && !counter[i].empty()) {
            counter[i].merge(carry);    // 链表合并,结果链表是有序的,必须保证合并前两个链表是有序的
            carry.swap(counter[i++]);   // 链表元素互换
        }
        carry.swap(counter[i]);
        if (i == fill) {       // i到达当前最大归并层次,说明得增加一层
            ++fill;
        }
    }

    for (int i = 1; i < fill; ++i) {  // 将所有归并层次的结果合并得到最终结果counter[fill - 1]
        counter[i].merge(counter[i - 1]);
    }
    l.swap(counter[fill - 1]);
}
Esta parte se puede consultar en
Arriba se ofrecen diagramas detallados del proceso.
Convertimos de nuevo G4.9 en la implementación externa correspondiente:
void sortList1(list<int> &l) {
    typedef list<int> list;
    if (l.size() <= 1) {
        return;
    }
    list __carry;
    list __tmp[64];
    list *__fill = &__tmp[0];
    list *__counter;
    do {
        __carry.splice(__carry.begin(), l, l.begin());
        for (__counter = &__tmp[0];
             __counter != __fill && !__counter->empty();
             ++__counter) {
            __counter->merge(__carry);
            __carry.swap(*__counter);
        }
        __carry.swap(*__counter);
        if (__counter == __fill) ++__fill;
    } while (!l.empty());

    for (__counter = &__tmp[1]; __counter != __fill; ++__counter)
        __counter->merge(*(__counter - 1));

    l.swap(*(__fill - 1));
}
Uso:
int main() {
    list<int> l = {7, 5, 8, 1};
    cout << "===============排序前==============" << endl;
    for (auto i:l) cout << i << " ";
    cout << endl;
    sortList1(l);
    cout << "===============排序后==============" << endl;
    for (auto i:l) cout << i << " ";
    cout << endl;

    return 0;
}
【Sobrecarga de operadores】
template<typename _Tp, typename _Alloc>
inline bool
operator==(const list<_Tp, _Alloc> &__x, const list<_Tp, _Alloc> &__y) {
    typedef typename list<_Tp, _Alloc>::const_iterator const_iterator;
    const_iterator __end1 = __x.end();
    const_iterator __end2 = __y.end();

    const_iterator __i1 = __x.begin();
    const_iterator __i2 = __y.begin();
    while (__i1 != __end1 && __i2 != __end2 && *__i1 == *__i2) {
        ++__i1;
        ++__i2;
    }
    return __i1 == __end1 && __i2 == __end2;
}
La idea de implementación es ir comprobando iterativamente si ambos iteradores han llegado al final.
Lo que quedan son otras sobrecargas de operadores, bastante sencillas, que no se explicarán. Entre ellas, lexicographical_compare está implementada en c++-v3/src/c++98/stl_algobase.h; esa función comprueba, según el orden lexicográfico, si [frist1,last1) es menor que [first2,last2). La función compara usando opeartor< o comp. Su comportamiento es similar a esto: si las dos secuencias tienen longitudes distintas y la corta coincide plenamente con el principio de la larga, por ejemplo example y examplee, entonces la de mayor longitud es lexicográficamente mayor que la corta.
template <class InputIterator1, class InputIterator2>
bool lexicographical_compare (InputIterator1 first1, InputIterator1 last1,
InputIterator2 first2, InputIterator2 last2)
{
    while (first1!=last1)
    {
        if (first2==last2 || *first2<*first1) return false;
        else if (*first1<*first2) return true;
        ++first1; ++first2;
    }
    return (first2!=last2);
}
Uso:
int main() {
     vector<char> v1{'h','e','l','l','o'};
    vector<char> v2{'h','e','l','l','o','o'};
    vector<char> v3{'h','e','l','m','o'};
    cout<<"v1=";
    for(char i:v1)
        cout<<i<<" ";
    cout<<endl;
    cout<<"v2=";
    for(char i:v2)
        cout<<i<<" ";
    cout<<endl;
    cout<<"v3=";
    for(char i:v3)
        cout<<i<<" ";
    cout<<endl;

    if(lexicographical_compare(v1.begin(),v1.end(),v2.begin(),v2.end()))
        cout<<"v1 is less than v2 "<<endl;
    else
        cout<<"v2 is less than v1 "<<endl;

    if(lexicographical_compare(v1.begin(),v1.end(),v3.begin(),v3.end()))
        cout<<"v1 is less than v3 "<<endl;
    else
        cout<<"v3 is less than v1 "<<endl;
}
Las demás sobrecargas de operadores son las siguientes:
template<typename _Tp, typename _Alloc>
inline bool
operator<(const list<_Tp, _Alloc> &__x, const list<_Tp, _Alloc> &__y) {
    return std::lexicographical_compare(__x.begin(), __x.end(),
                                        __y.begin(), __y.end());
}

/// Based on operator==
template<typename _Tp, typename _Alloc>
inline bool
operator!=(const list<_Tp, _Alloc> &__x, const list<_Tp, _Alloc> &__y) { return !(__x == __y); }

/// Based on operator<
template<typename _Tp, typename _Alloc>
inline bool
operator>(const list<_Tp, _Alloc> &__x, const list<_Tp, _Alloc> &__y) { return __y < __x; }

/// Based on operator<
template<typename _Tp, typename _Alloc>
inline bool
operator<=(const list<_Tp, _Alloc> &__x, const list<_Tp, _Alloc> &__y) { return !(__y < __x); }

/// Based on operator<
template<typename _Tp, typename _Alloc>
inline bool
operator>=(const list<_Tp, _Alloc> &__x, const list<_Tp, _Alloc> &__y) { return !(__x < __y); }
1.2 Código fuente de la clase base de list
_list_base contiene una estructura: _List_impl, y _List_impl contiene un List_node_base.
class _List_base
{
protected:
  typedef typename _Alloc::template rebind<_List_node<_Tp> >::other
    _Node_alloc_type;

  typedef typename _Alloc::template rebind<_Tp>::other _Tp_alloc_type;

  struct _List_impl
  : public _Node_alloc_type
  {
    __detail::_List_node_base _M_node;

    _List_impl()
    : _Node_alloc_type(), _M_node()
    { }

    _List_impl(const _Node_alloc_type& __a) _GLIBCXX_NOEXCEPT
    : _Node_alloc_type(__a), _M_node()
    { }

    #if __cplusplus >= 201103L
    _List_impl(_Node_alloc_type&& __a) _GLIBCXX_NOEXCEPT
    : _Node_alloc_type(std::move(__a)), _M_node()
    { }
    #endif
  };

  _List_impl _M_impl;
};
El diagrama que finalmente se forma es:
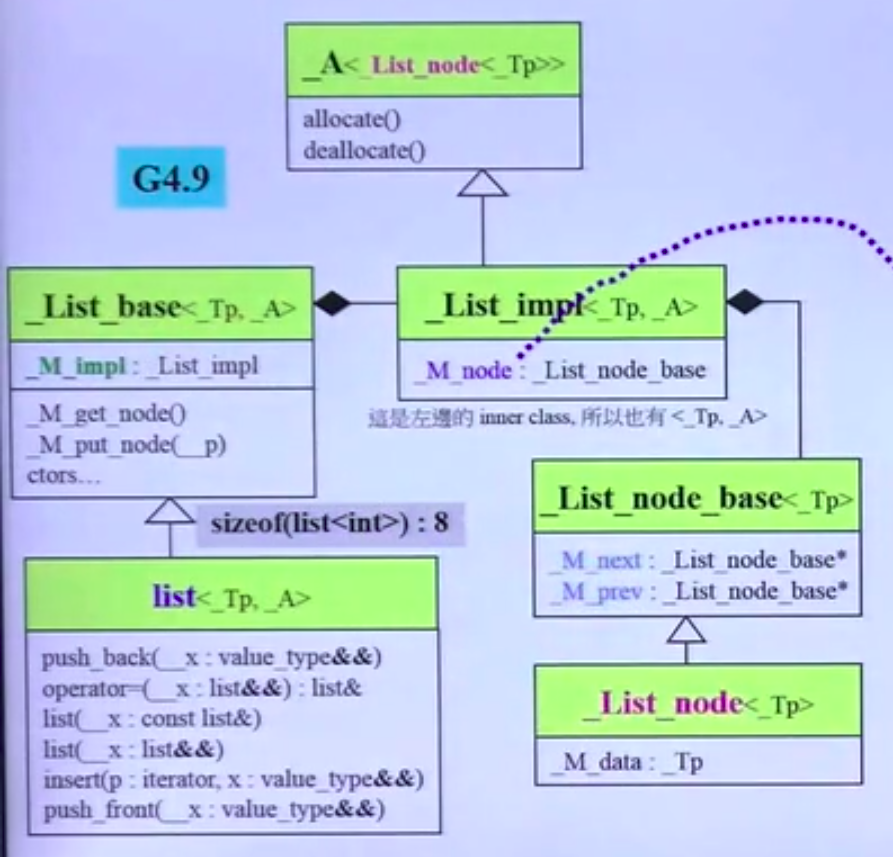
Así que si se calcula:
La razón es:
El sizeof de list es 1, así que el sizeof procede de la clase base _list_base; _list_base contiene una estructura _List_impl, y _List_impl contiene un _List_node_base.
Sabemos que _List_node_base tiene dentro dos punteros; en 64 bits, 8 bytes cada uno, 16 en total.
2. Análisis del Iterator de list
2.1 iterator
Definición del iterator de list
template<typename _Tp>
struct _List_iterator
{
  typedef _List_iterator<_Tp>                _Self;
  typedef _List_node<_Tp>                    _Node;

  typedef ptrdiff_t                          difference_type;
  typedef std::bidirectional_iterator_tag    iterator_category;
  typedef _Tp                                value_type;
  typedef _Tp*                               pointer;
  typedef _Tp&                               reference;

   // The only member points to the %list element.
   __detail::_List_node_base* _M_node;
   //  _List_node(节点的数据部分) -> _List_node_base(前指针与后指针)

  _List_iterator() _GLIBCXX_NOEXCEPT
  : _M_node() { }

  explicit
  _List_iterator(__detail::_List_node_base* __x) _GLIBCXX_NOEXCEPT
  : _M_node(__x) { }

  _Self
  _M_const_cast() const _GLIBCXX_NOEXCEPT
  { return *this; }

  // The only member points to the %list element.
  __detail::_List_node_base* _M_node;
};
Funciones sobrecargadas internas:
// Must downcast from _List_node_base to _List_node to get to _M_data.
// 重载*操作符
reference operator*() const _GLIBCXX_NOEXCEPT
{
    return static_cast<_Node*>(_M_node)->_M_data;
}

// 重载->操作符
pointer operator->() const _GLIBCXX_NOEXCEPT
{
    return std::__addressof(static_cast<_Node*>(_M_node)->_M_data);
}

// 重载前置++操作符  ++i
_Self& operator++() _GLIBCXX_NOEXCEPT
{
    _M_node = _M_node->_M_next;
    return *this;
}

// 重载后置++操作符 i++
_Self operator++(int) _GLIBCXX_NOEXCEPT
{
    _Self __tmp = *this;             // 记录原值  *调用的是拷贝构造函数
    _M_node = _M_node->_M_next;      // 进行操作
    return __tmp;                    // 返回原值
}

// 重载前置--操作符  --i
_Self& operator--() _GLIBCXX_NOEXCEPT
{
    _M_node = _M_node->_M_prev;
    return *this;
}
// 重载后置--操作符  --i
_Self operator--(int) _GLIBCXX_NOEXCEPT
{
    _Self __tmp = *this;
    _M_node = _M_node->_M_prev;
    return __tmp;
}
// 重载++操作符
bool operator==(const _Self& __x) const _GLIBCXX_NOEXCEPT
{
    return _M_node == __x._M_node;
}
// 重载!=操作符
bool operator!=(const _Self& __x) const _GLIBCXX_NOEXCEPT
{
    return _M_node != __x._M_node;
}
2.2 Diseño del nodo
El _List_node interno del iterator: aquí se ve que hereda de _List_node_base.
_List_node guarda la parte de datos
_List_node_base guarda los punteros anterior y posterior
/// An actual node in the %list.
template<typename _Tp>
struct _List_node : public __detail::_List_node_base
{
  ///< User's data.
  _Tp _M_data;

#if __cplusplus >= 201103L
  template<typename... _Args>
    _List_node(_Args&&... __args)
: __detail::_List_node_base(), _M_data(std::forward<_Args>(__args)...)
    { }
#endif
};
Código de _List_node_base:
namespace __detail
{
    _GLIBCXX_BEGIN_NAMESPACE_VERSION
    /// Common part of a node in the %list.
    struct _List_node_base
    {
      _List_node_base* _M_next;
      _List_node_base* _M_prev;

      static void
      swap(_List_node_base& __x, _List_node_base& __y) _GLIBCXX_USE_NOEXCEPT;

      void
      _M_transfer(_List_node_base* const __first,
          _List_node_base* const __last) _GLIBCXX_USE_NOEXCEPT;

      void
      _M_reverse() _GLIBCXX_USE_NOEXCEPT;

      void
      _M_hook(_List_node_base* const __position) _GLIBCXX_USE_NOEXCEPT;

      void
      _M_unhook() _GLIBCXX_USE_NOEXCEPT;
    };

    _GLIBCXX_END_NAMESPACE_VERSION
} // namespace detail
Al diseñar el iterador se mantiene siempre el principio de intervalo cerrado por la izquierda y abierto por la derecha: por ejemplo, iter->begin() apunta al primer elemento e iter->end() apunta al elemento siguiente al último real; por eso el diseño final añade deliberadamente un nodo vacío al final de la lista circular, para ajustarse al principio STL de cerrado por la izquierda y abierto por la derecha.
Temas relacionados
- Análisis del código fuente de STL array | C++那些事
- Análisis profundo de STL string | C++那些事
- STL string preguntas de entrevista explicadas | C++那些事
- Análisis del código fuente de STL deque | C++那些事
- STL optimización de clase base vacía EBO | C++那些事
- STL implementación de una tabla hash escrita a mano | C++那些事
- STL hashtable tabla hash | C++那些事
- Análisis del código fuente de los iteradores STL | C++那些事
- STL map y multimap | C++那些事
- Análisis del código fuente de STL queue y stack | C++那些事