Última actualización:2026-10-12
STL paralelo de C++17
1. Grado de soporte de cada compilador
El soporte de la biblioteca de algoritmos paralelos en los distintos compiladores es el siguiente:
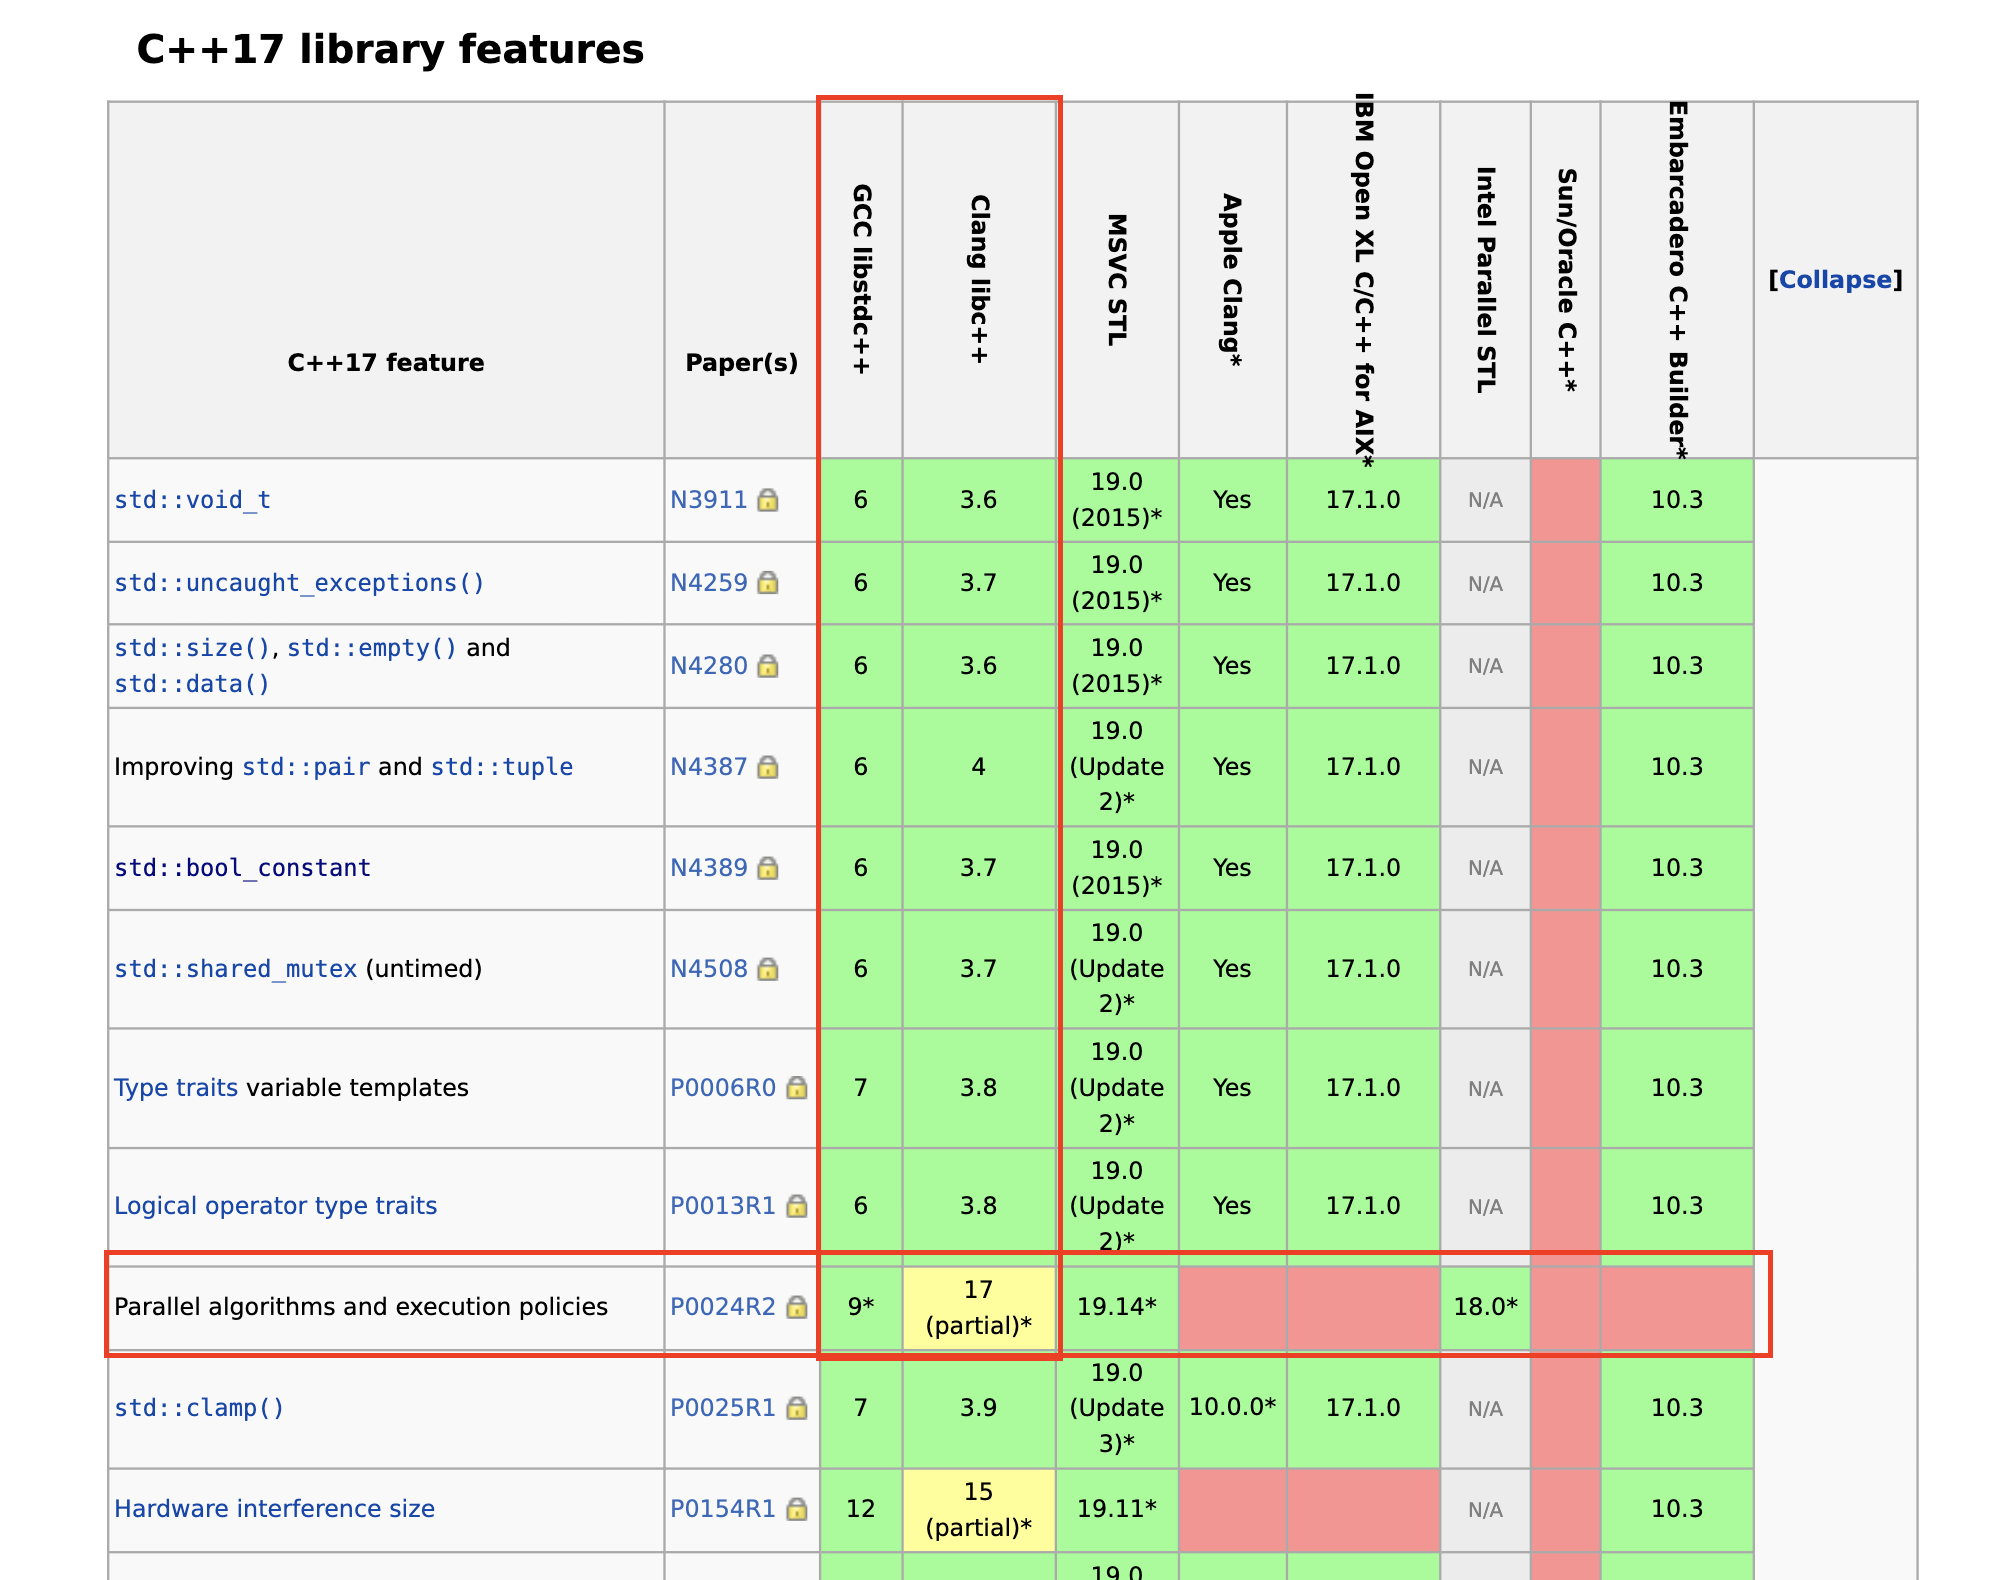
https://en.cppreference.com/w/cpp/compiler_support/17#C.2B.2B17_library_features
Se puede ver que gcc ya la admite a partir de gcc9, mientras que clang aún no la soporta por completo; lo comprobé en local y, en efecto, no la admite.
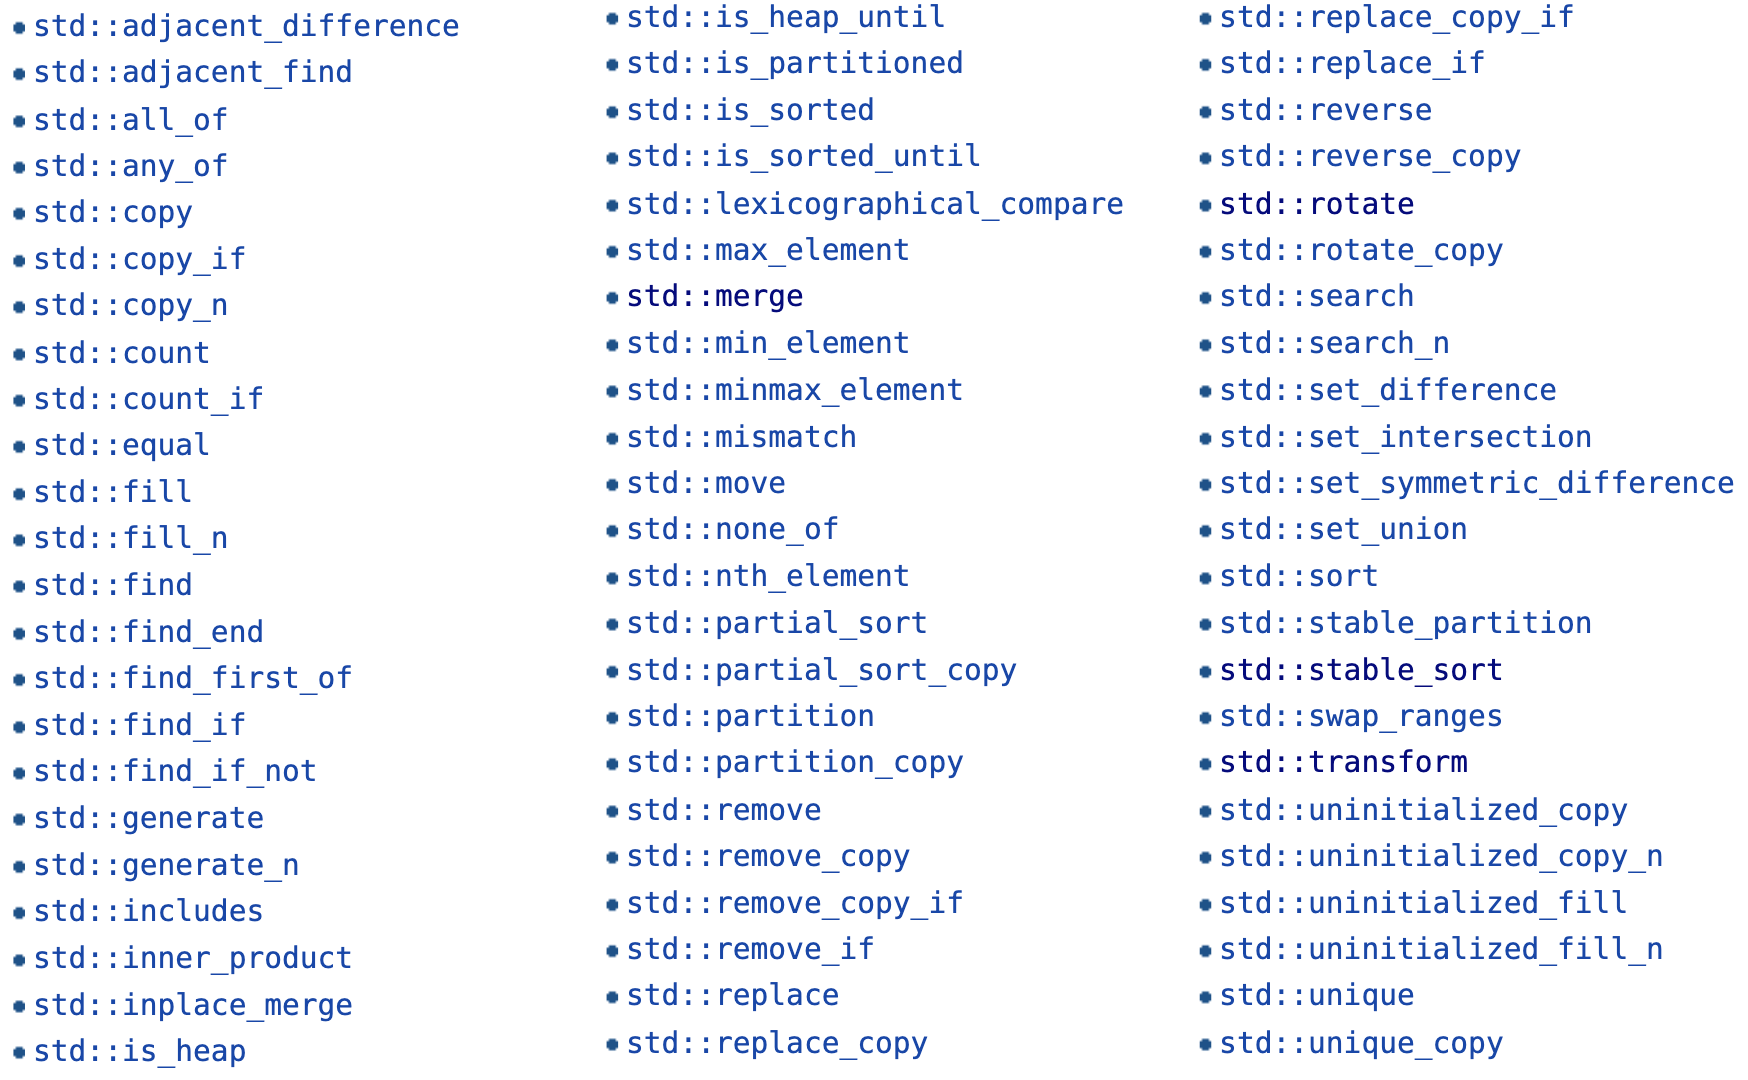
Los algoritmos admitidos incluyen:
2. Requisitos de la biblioteca de algoritmos paralelos
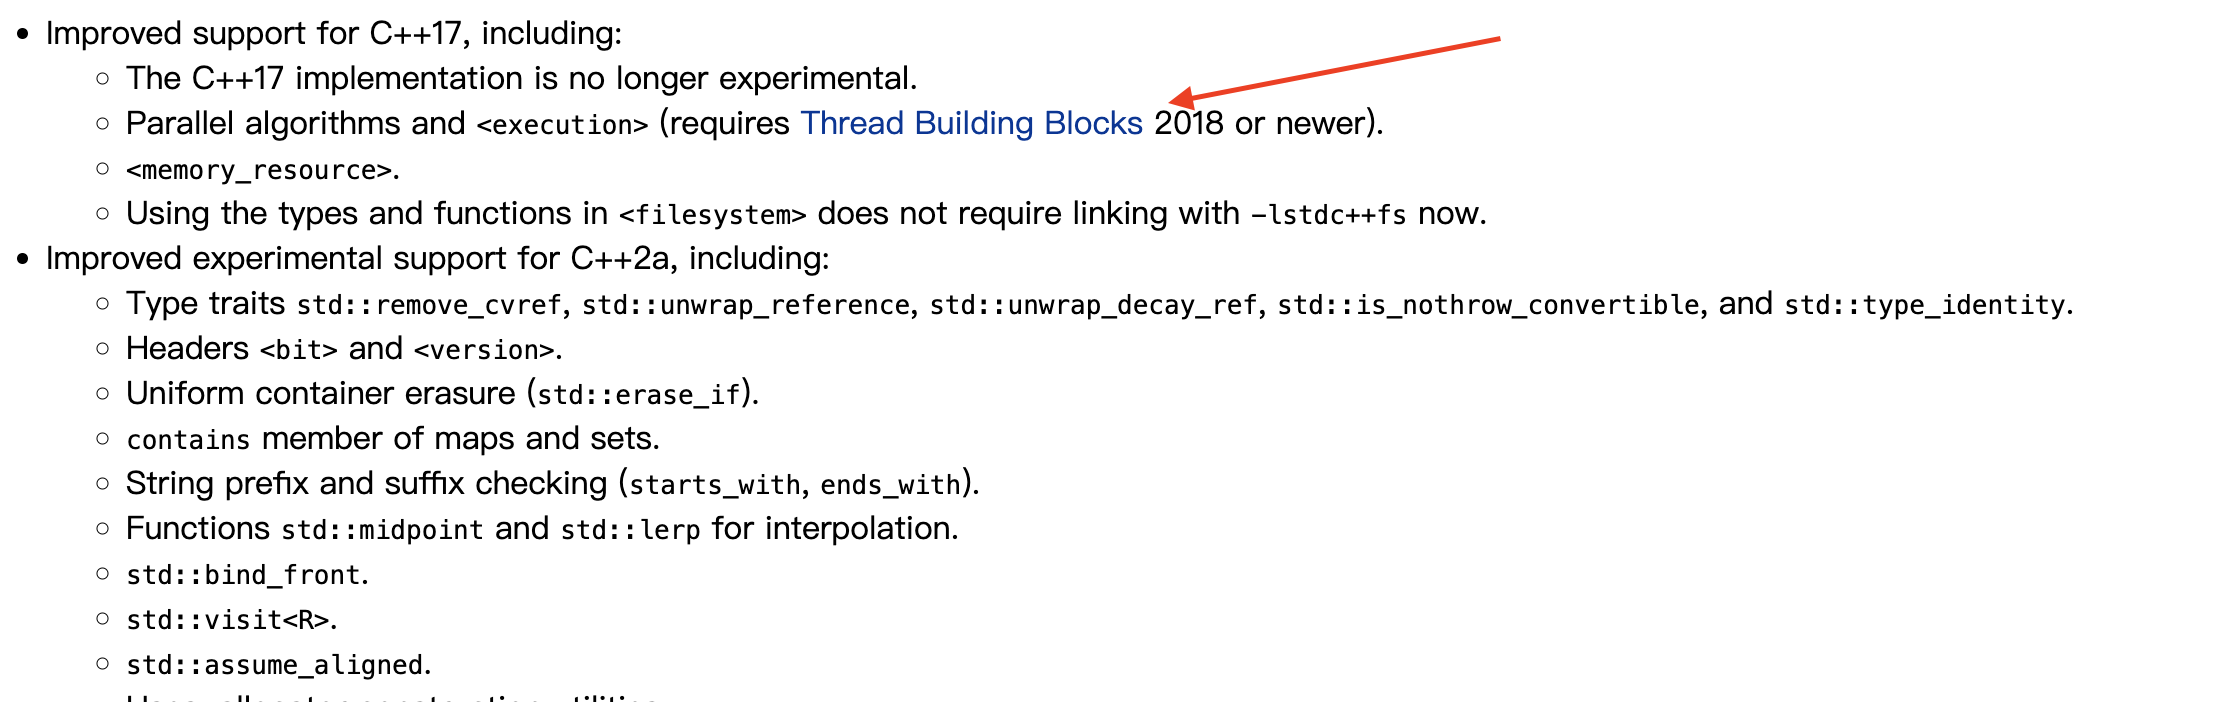
A partir de gcc9 ya se puede usar la biblioteca de algoritmos paralelos; podemos consultar la documentación de gcc-9 siguiente.
En ella se menciona un dato muy importante: requiere soporte de tbb.
TBB es una biblioteca C++ para programación paralela desarrollada por Intel. TBB busca simplificar el desarrollo de software paralelo en procesadores multinúcleo y proporciona un conjunto de abstracciones y modelos que permiten a los programadores implementar algoritmos paralelos con mayor facilidad.
1.Para usar la biblioteca de algoritmos paralelos en C++17 es imprescindible tener tbb instalado; ¿y qué ocurre si no se instala tbb?
Por mi propia experiencia: compila y se ejecuta, solo que sin ninguna aceleración; el resultado es el mismo que el de la versión no paralela original.
2.¿Cómo se instala TBB?
Una es la tbb oficial, llamada oneTBB.
La otra es una tbb escrita por terceros, llamada tbb.
La diferencia es que añade un sistema de compilación basado en CMake.
Ahora la oficial también admite cmake, así que recomiendo usar la oficial.
Compilar también es muy sencillo:
3. Cómo usarla
¿Qué cambios hay respecto al uso tradicional de la STL?
1. Nivel de interfaz
En realidad es bastante sencillo; por ejemplo, sort antes era:
y ahora pasa a ser:
Solo hay que añadir la política de ejecución (execution policy), con tres opciones:
std::execution::seq(ejecución secuencial):- Es la política de ejecución por defecto; es decir, si no especificas una política de ejecución, el algoritmo usará la ejecución secuencial.
- El algoritmo procesa los elementos uno tras otro en orden, sin paralelismo.
std::execution::par(ejecución paralela):- Con esta política de ejecución se activa la ejecución paralela. El algoritmo intenta procesar los elementos de forma paralela, aprovechando al máximo los procesadores multinúcleo.
std::execution::par_unseq(ejecución paralela y vectorizada):- Esta política permite que el algoritmo vectorice (vectorization) al mismo tiempo que paraleliza, lo que significa que puede aprovechar los juegos de instrucciones SIMD (Single Instruction, Multiple Data) para operaciones paralelas vectorizadas.
- A diferencia de
std::execution::par,par_unseqpermite el procesamiento vectorizado además del paralelo, sacando así mejor partido de las capacidades de paralelización y vectorización del hardware.
2. Nivel de archivos de cabecera
Es imprescindible incluir:
Si hay operaciones de tbb, se pueden incluir las cabeceras de tbb, por ejemplo para fijar el número de hilos.
3. Nivel de compilación
Al compilar hay que indicar la información de enlazado, por ejemplo:
g++ -O3 -std=c++17 -Wall -Wextra -pedantic -I/usr/local/include/tbb -L /usr/local/lib/ -o main.out main.cc -ltbb
4. Pruebas de rendimiento
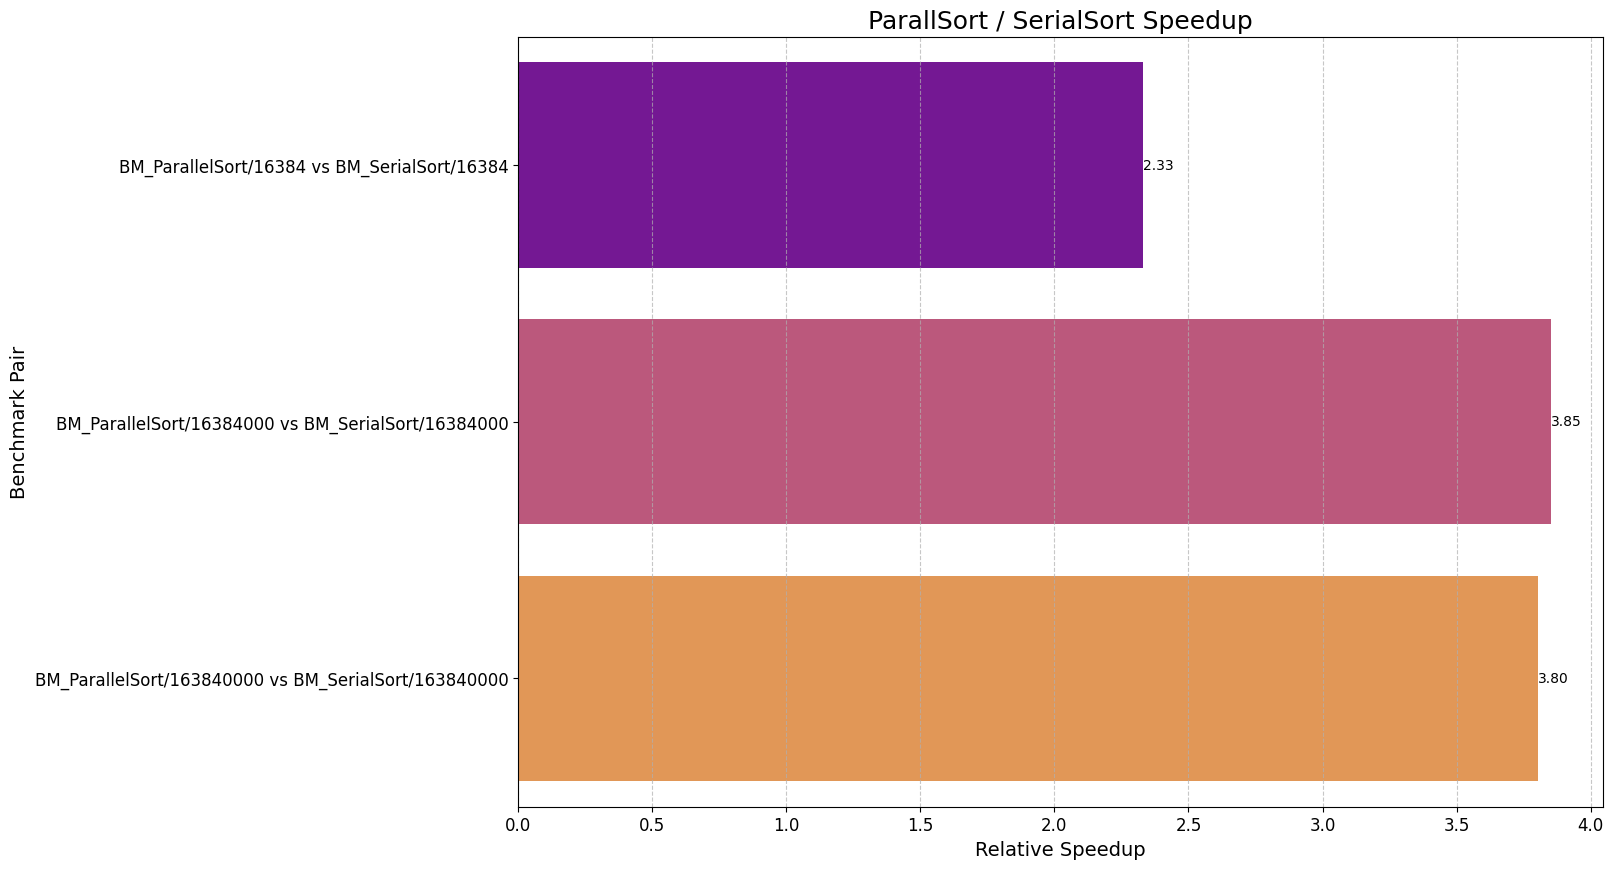
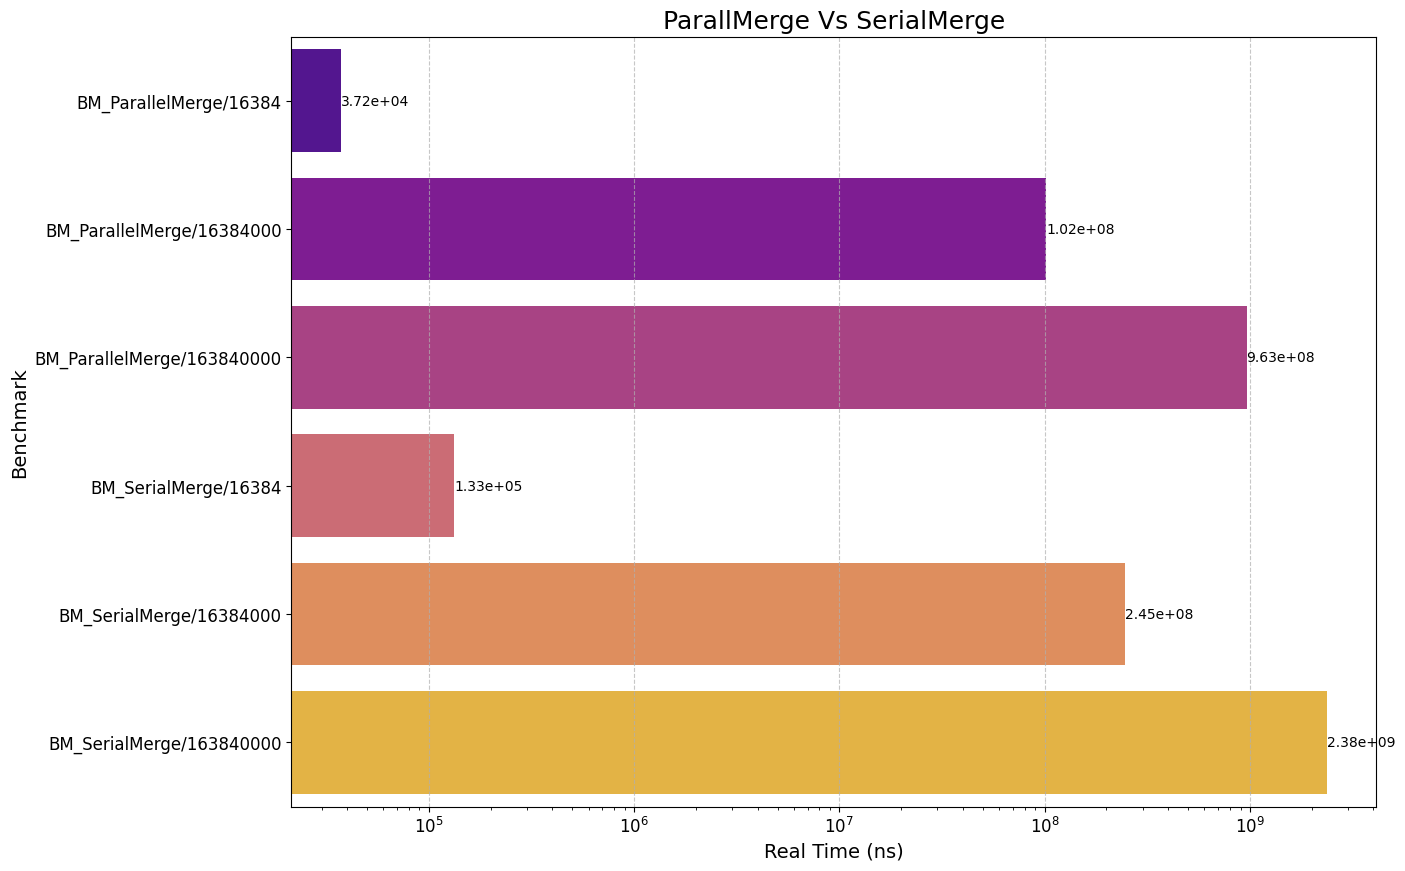
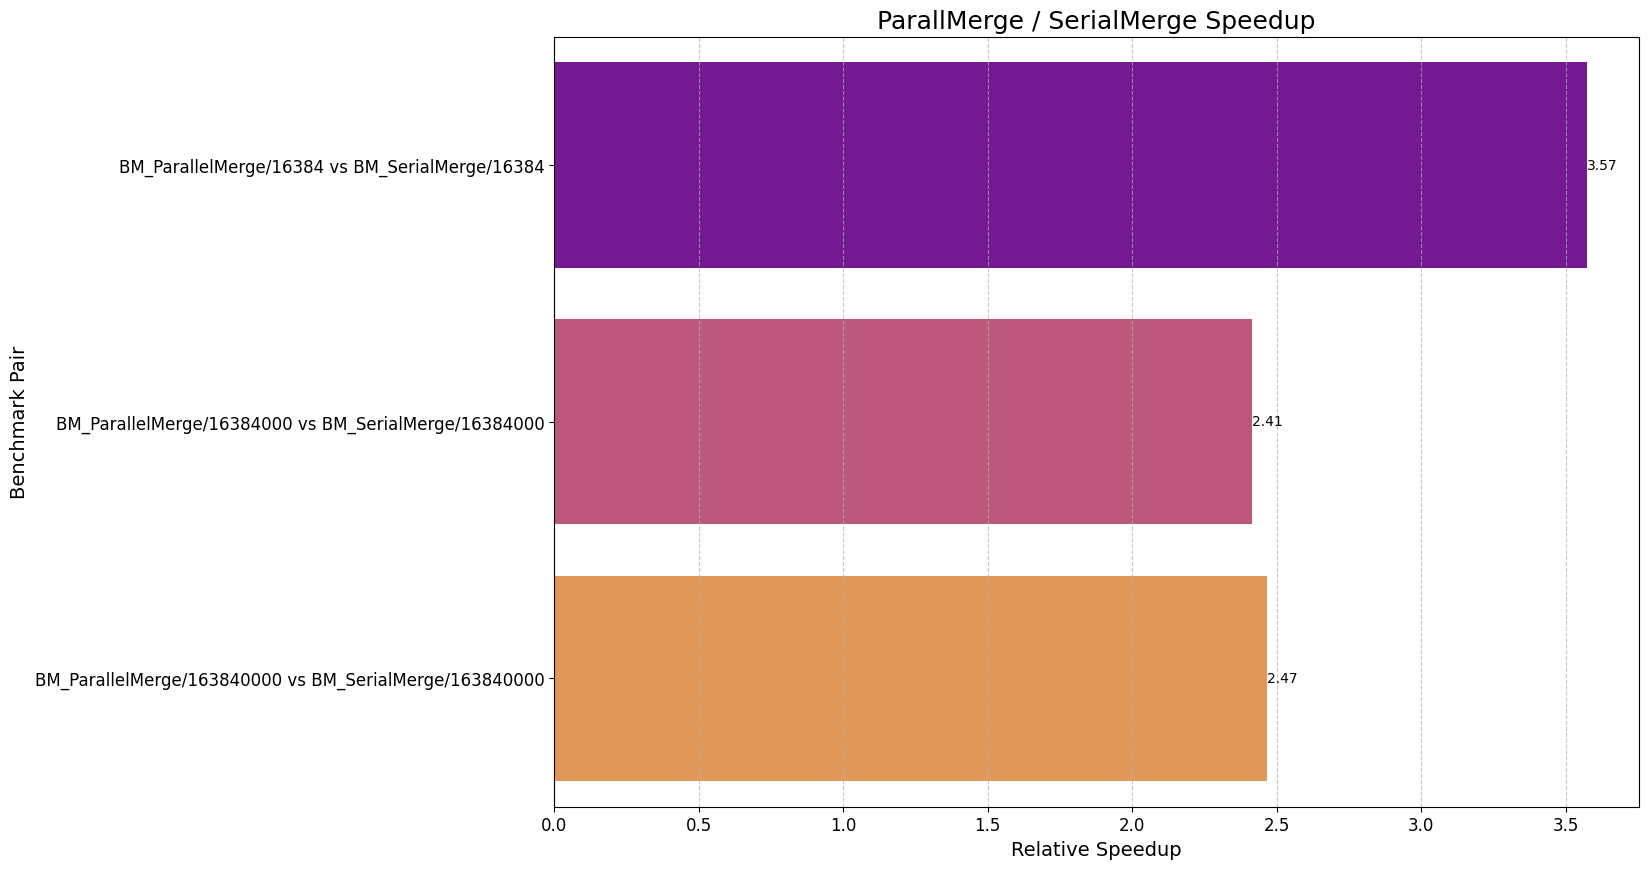
Últimamente trabajo en temas relacionados con sort y quería comparar el rendimiento de merge y sort, así que escribí un benchmark con la siguiente lógica:
-
sort serial vs sort paralelo (política par)
-
merge serial vs merge paralelo (política par)
Rango de datos:
Los resultados de las pruebas siguientes usan la política de planificación de hilos por defecto de tbb.
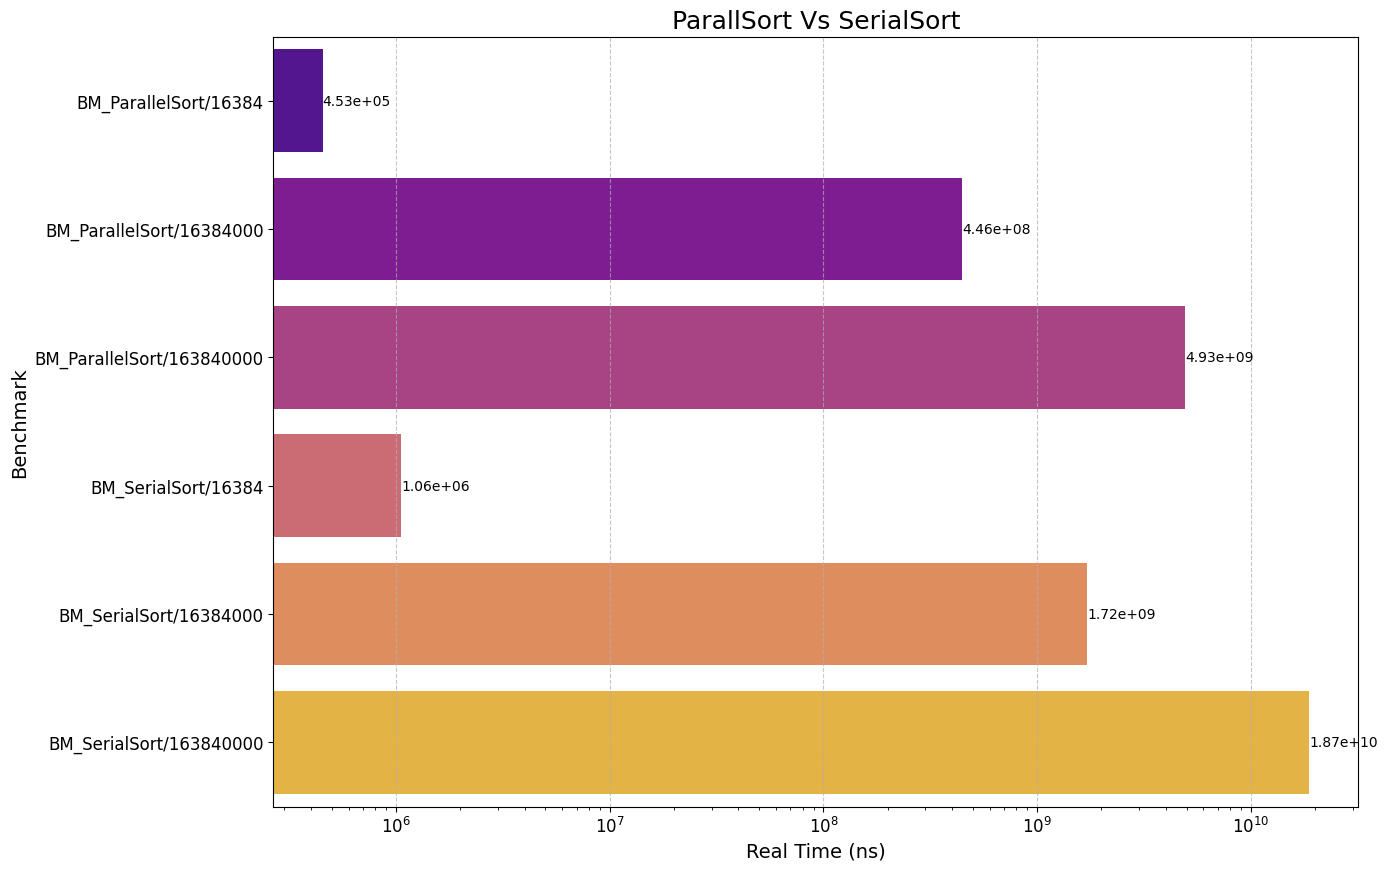
Grupo de comparación 1: datos detallados y factor de aceleración de sort paralelo/sort serial
Grupo de comparación 2: datos detallados y factor de aceleración de merge paralelo/merge serial
Documentación de tbb:
Si quieres fijar el número de hilos, puedes hacerlo así:
Temas relacionados
- Guía de lectura de C++ Concurrency in Action | C++那些事
- Localización de interbloqueos en C++ | C++那些事
- Vectorización SIMD en C++ | C++那些事
- False Sharing y líneas de caché en C++ | C++那些事
- Depuración multihilo All-Stop con GDB | C++那些事
- Detección de errores de concurrencia con Helgrind | C++那些事
- Principios del bucle de eventos de libev | C++那些事
- Implementación interna de std::thread en C++ | C++那些事
- std::thread y jthread en C++ | C++那些事
- Introducción al multihilo en C++ | C++那些事