Последнее обновление:2026-10-12
Тест производительности SSO в C++ string
Сегодня хочу задать вам два вопроса:
1.Есть ли разница в производительности у приведённого ниже кода?
2.Чему равен sizeof(std::string)?
Давайте вместе разберём эти два вопроса.
Поскольку ответы на них различаются для g++(libstdc++) и clang(libc++), разберём их по отдельности.
1.g++(libstdc++)
За исходный код g++ возьмём g++-10; подробный код можно посмотреть по этому адресу на github — здесь приведу лишь наиболее ключевые фрагменты.
template<typename _CharT, typename _Traits, typename _Alloc>
class basic_string {
  private:
    struct _Alloc_hider : allocator_type {
        pointer _M_p; // The actual data.
    };
      enum { __min_cap = 15 / sizeof(value_type) };
    _Alloc_hider    _M_dataplus;             //  8 bytes
    size_type __size_;                     //  8 bytes

    union {
            _CharT           _M_local_buf[_S_local_capacity + 1]; // 16 bytes
            size_type        _M_allocated_capacity;                             // 8 bytes
    }; // 16 bytes
}; // 32 bytes
В комментариях к приведённому коду подробно перечислены байты, занимаемые string (обратите внимание: value_type здесь считается для char, то есть sizeof(value_type) = 1).
sizeof(string) = 8 + 8 + 16 = 32.
Из них 8 байт на ptr, 8 байт на size и 16 байт на union.
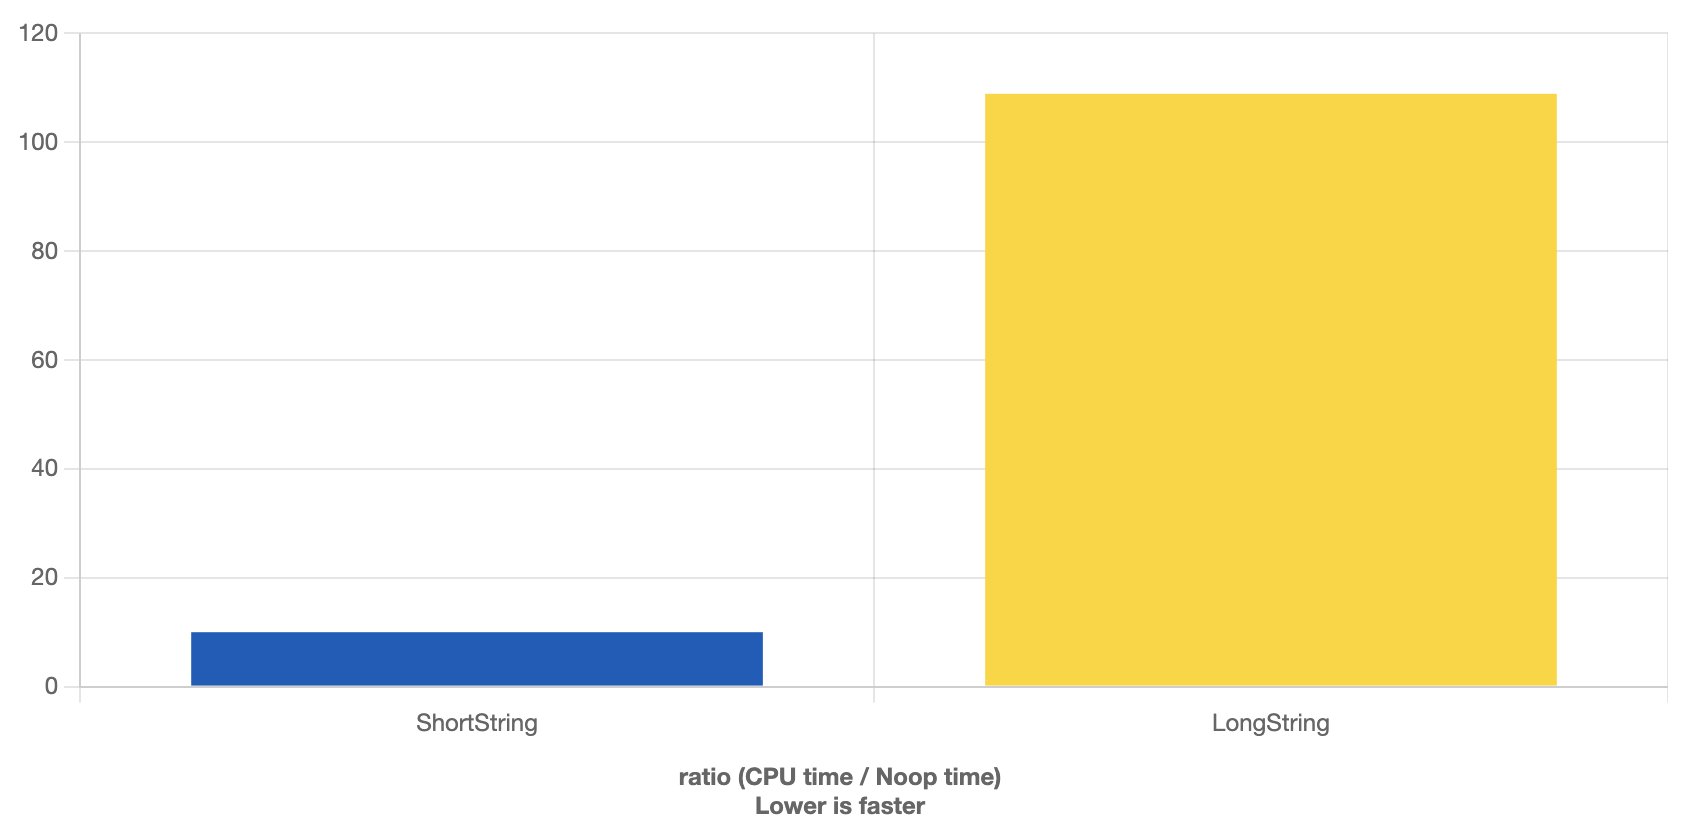
С точки зрения производительности здесь реализована SSO: локальный буфер хранит максимум 15 символов, а при превышении 15 символов происходит выделение в heap; я написал benchmark, чтобы сравнить производительность.
- Содержимое короткой строки для теста: "hello world hel", всего 15 символов.
- Содержимое длинной строки для теста: "hello world helo", всего 16 символов.
Видно, что разница в производительности огромна — всего один символ настолько меняет производительность std::string!
По сути, дело всё в том же SSO local buffer.
Тест производительности: https://quick-bench.com/q/s7pvDB_SwQyDCcZk50odAaYIzMc
2.clang++(libc++)
Аналогично возьмём llvm-14; если хотите посмотреть полный код — откройте адрес на github ниже, здесь я приведу ключевые фрагменты.
https://github.com/llvm/llvm-project/blob/release/14.x/libcxx/include/string#L765
template<class _CharT, class _Traits, class _Allocator>
class basic_string {
  private:
    struct __long {
        size_type __cap_;               // 8 bytes
        size_type __size_;              // 8 bytes
        pointer   __data_;              // 8 bytes
    };

        enum {__min_cap = (sizeof(__long) - 1)/sizeof(value_type) > 2 ?
                      (sizeof(__long) - 1)/sizeof(value_type) : 2};

    struct __short {
        union {
            unsigned char __size_;      // 1 bytes
            value_type __lx;            // 1 bytes
        };                              // 1 bytes
        value_type __data_[__min_cap];  // 23 bytes
    };                                  // 24 bytes

        union __ulx {
            __long __lx;        // 24 bytes
            __short __lxx;  // 24 bytes
        }; // 24 bytes
}
В комментариях к приведённому коду подробно перечислены байты, занимаемые string (обратите внимание: value_type здесь считается для char, то есть sizeof(value_type) = 1).
sizeof(string) равен размеру union; этот union занимает 24 байта, поэтому итог равен 24.
Что касается SSO, локальный буфер хранит не более 22 символов, а при превышении 22 символов происходит выделение в heap.
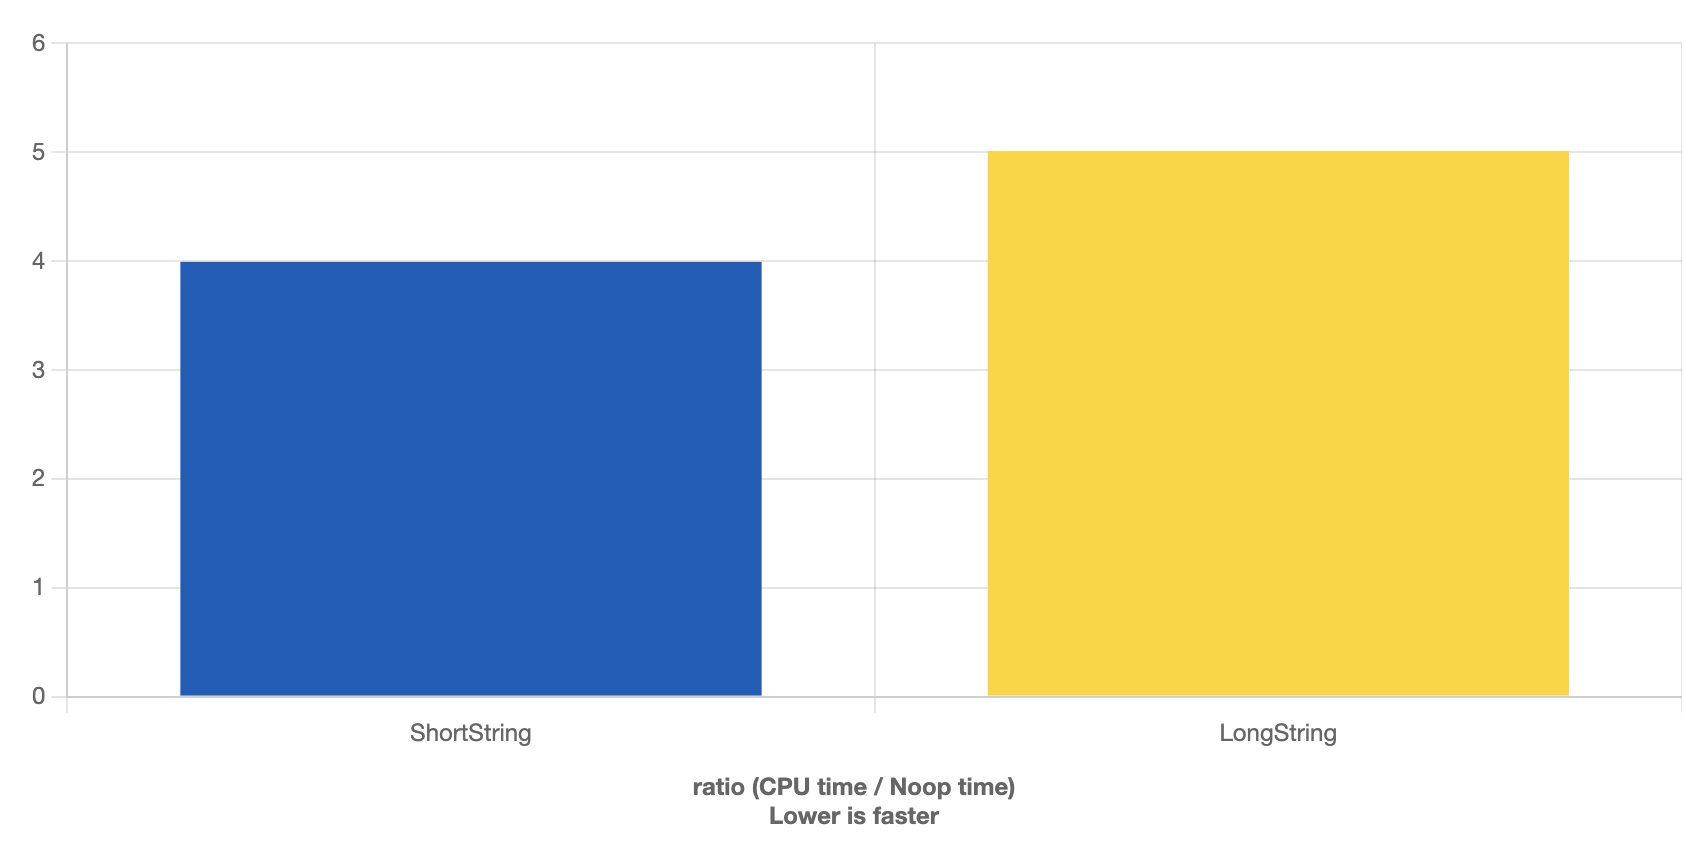
Поэтому, когда мы применили на clang тот же тестовый код, что и для gcc, результат получился несколько иным: производительность для long-строки почти не отличается от производительности для short-строки. Причина в том, что тестовые сценарии gcc укладывались в 22 символа — все они были короткими.
Тест производительности: https://quick-bench.com/q/nmLMqQZ31cmWBbbIFr2nHN2JL1k
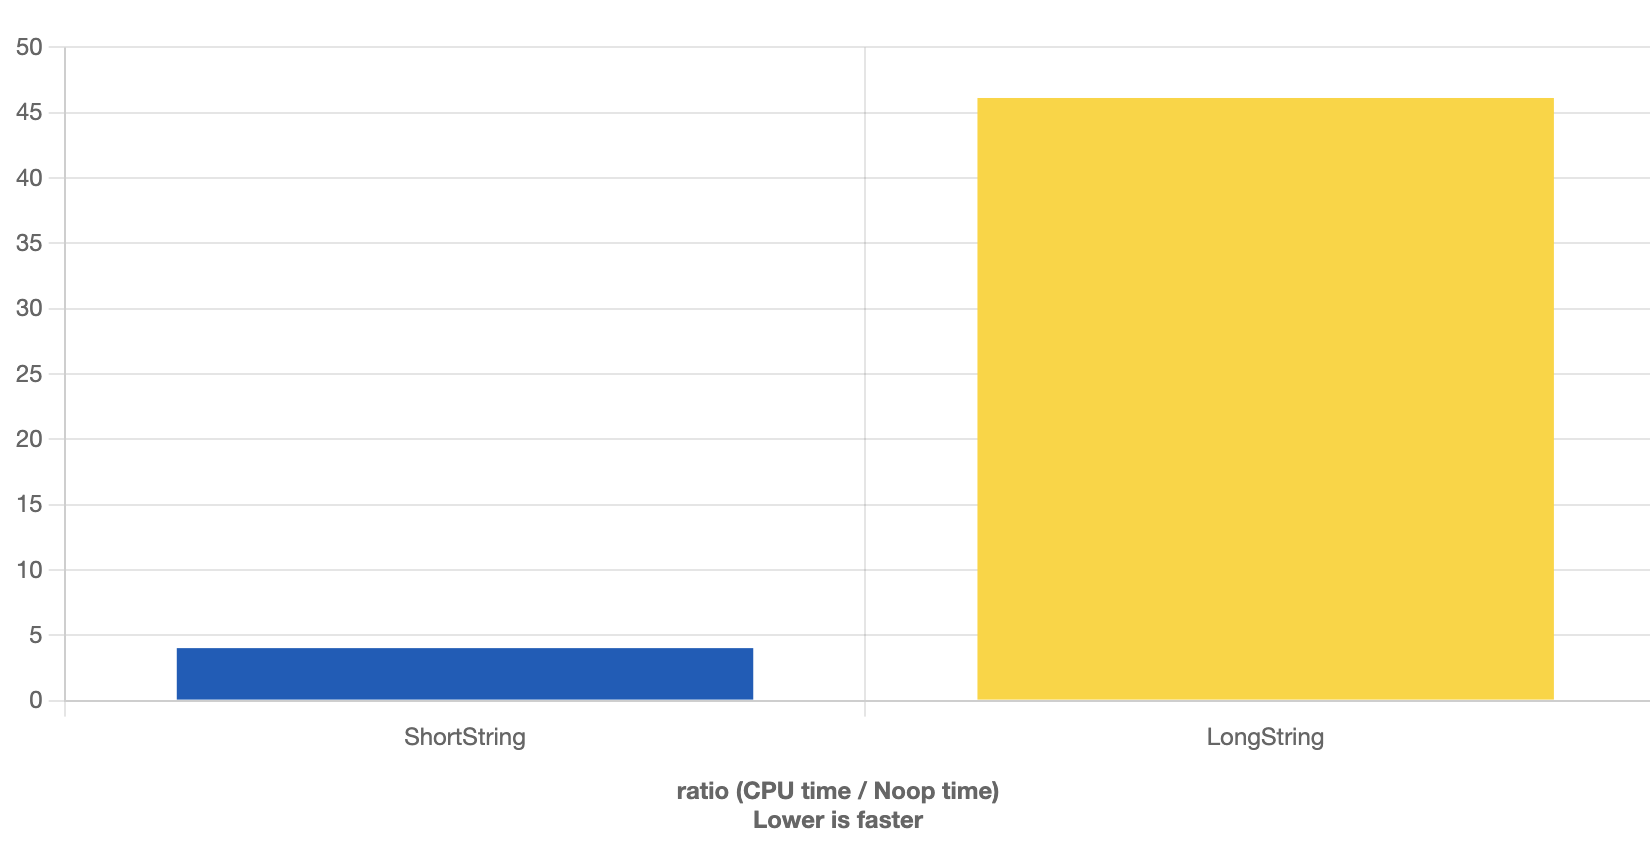
Когда же мы тестируем по-настоящему длинные и короткие строки, производительность меняется заметно, и тренд совпадает с gcc.
- Содержимое короткой строки для теста: "hello world hello worl", всего 22 символа.
- Содержимое длинной строки для теста: "hello world hello world", всего 23 символа.
Тест производительности: https://quick-bench.com/q/ujtMrtotEi6RrpfMDJ1UcSLFIJE
Похожие темы
- Сравнение производительности memcpy и std::copy | C++那些事
- Полиморфизм в C++: виртуальные функции, CRTP и variant | C++那些事