Última atualização:2026-10-12
STL Paralela do C++17
1.Estado de suporte dos compiladores
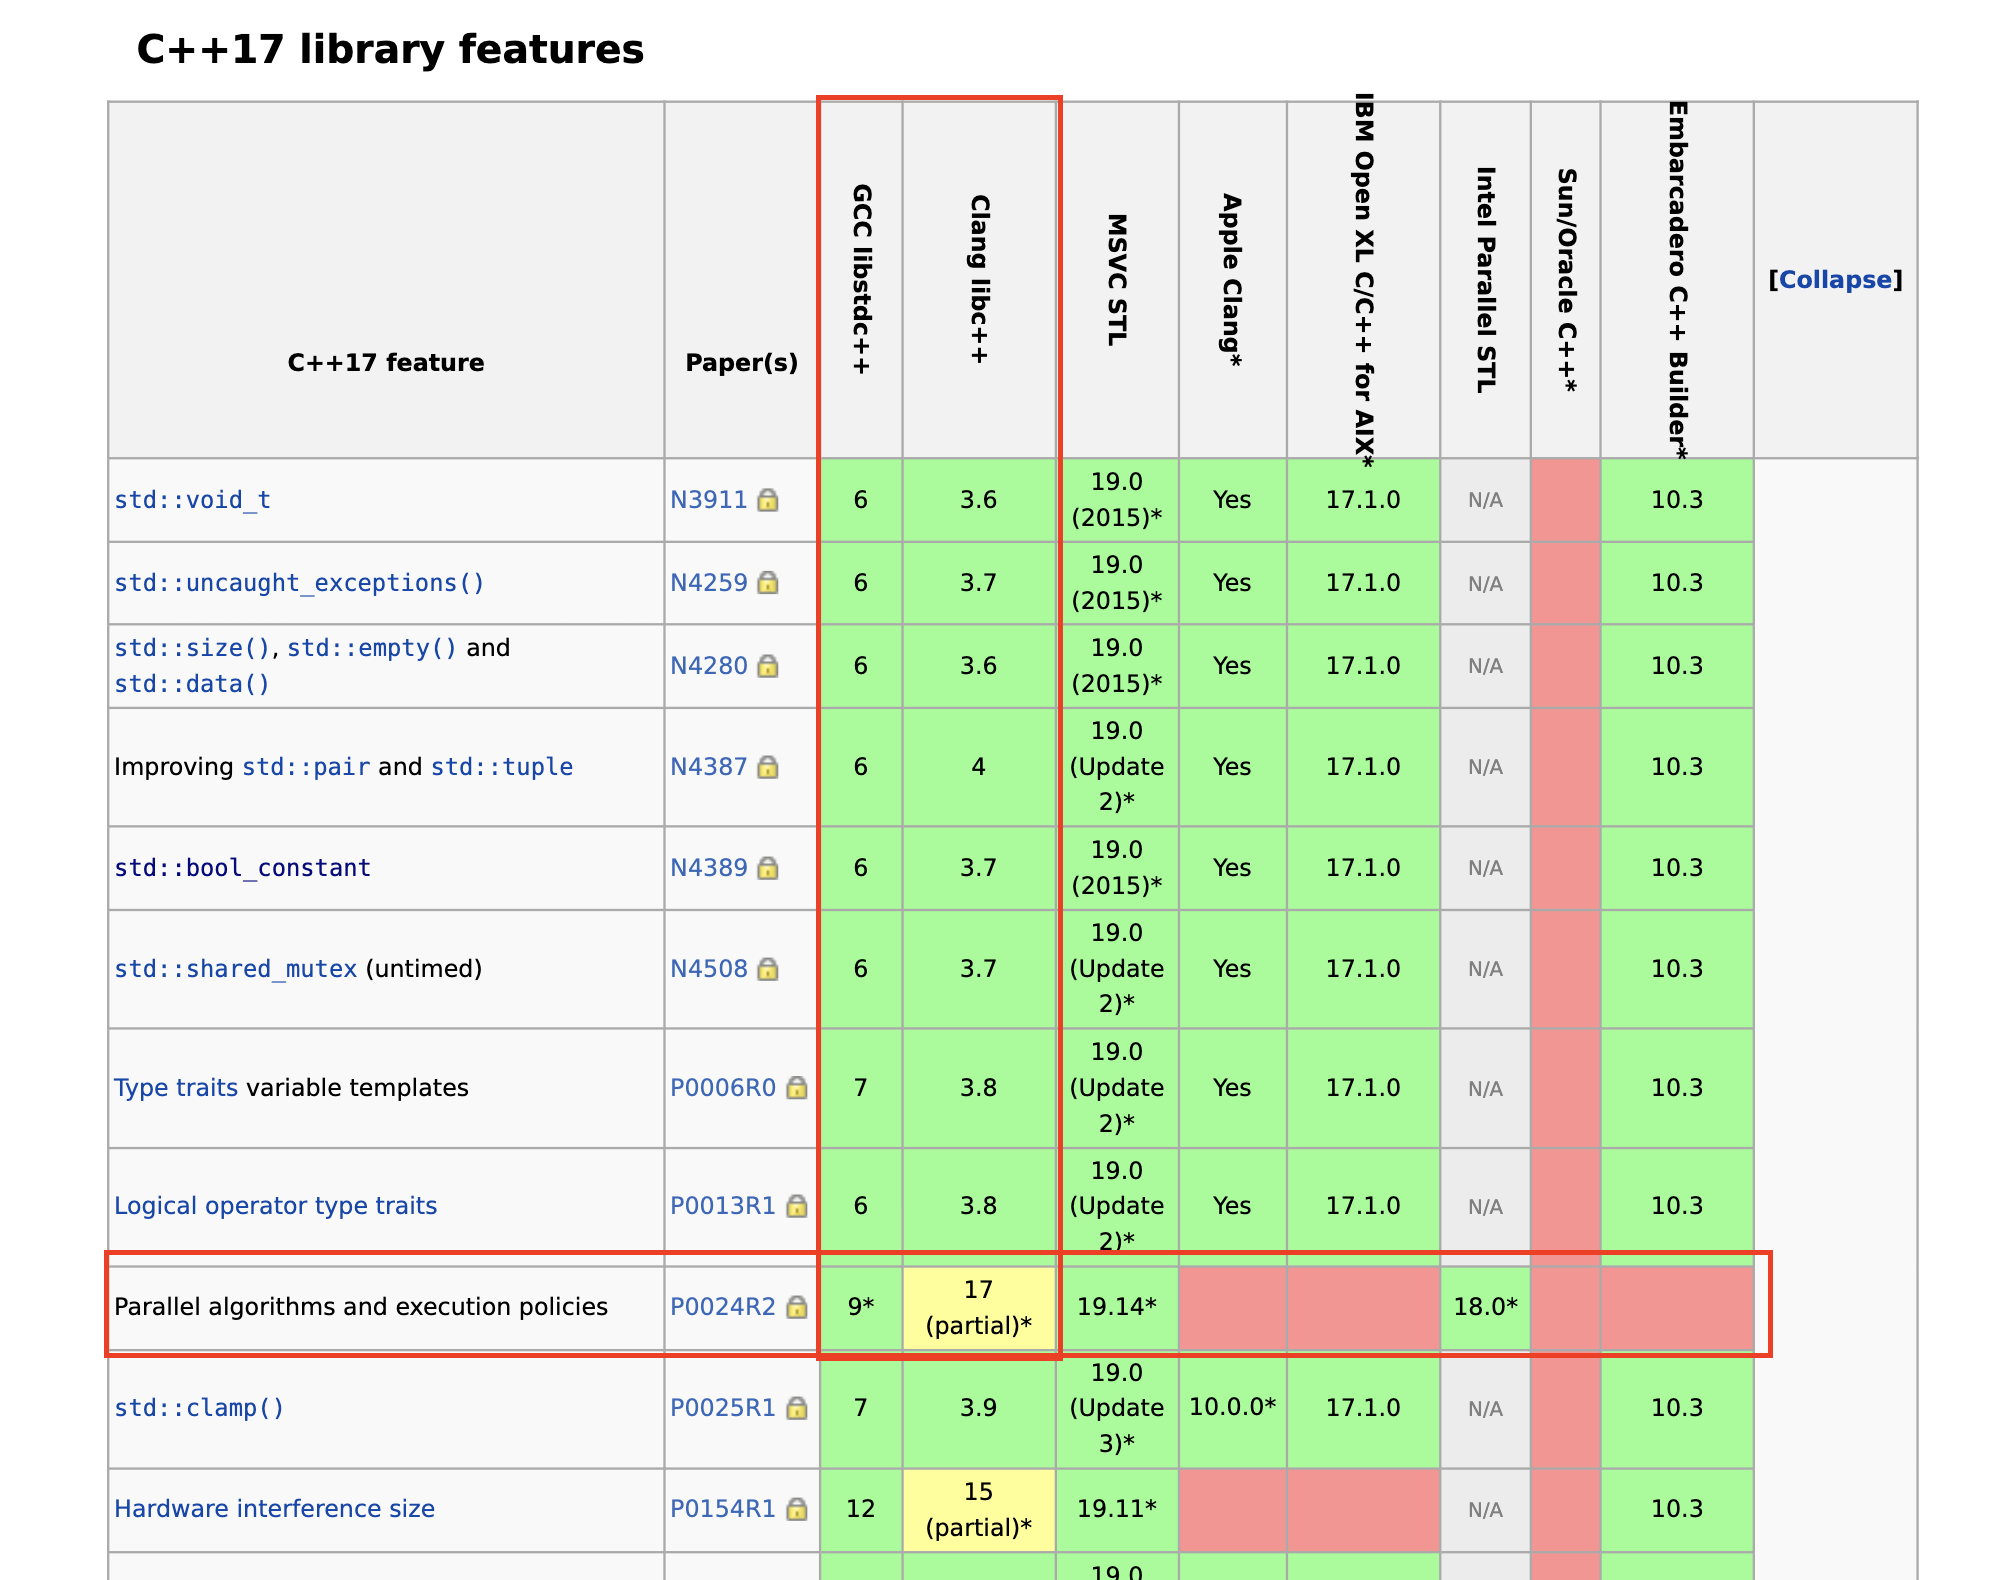
O suporte dos diferentes compiladores à biblioteca de algoritmos paralelos é o seguinte:
https://en.cppreference.com/w/cpp/compiler_support/17#C.2B.2B17_library_features
Pode-se ver que o gcc 9 em diante já oferece suporte; o clang ainda não oferece suporte completo — testei localmente e de fato não funciona.
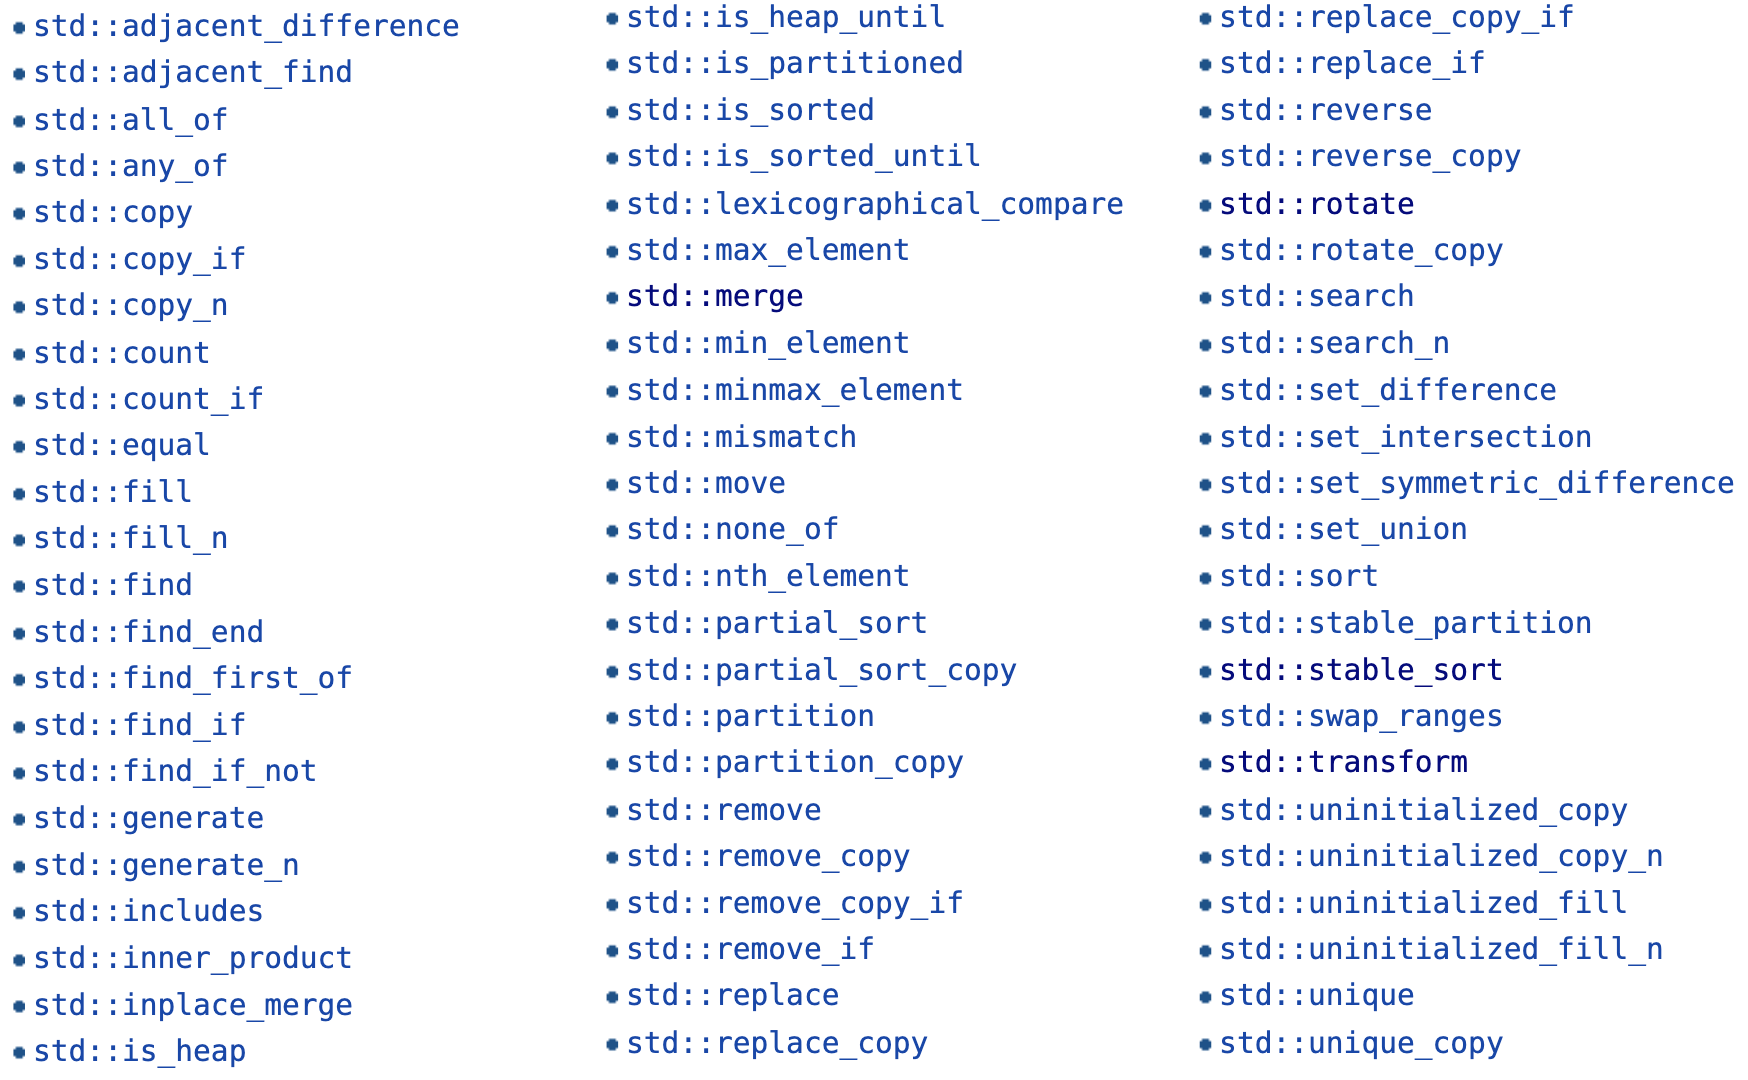
Os algoritmos suportados incluem:
2.Requisitos da biblioteca de algoritmos paralelos
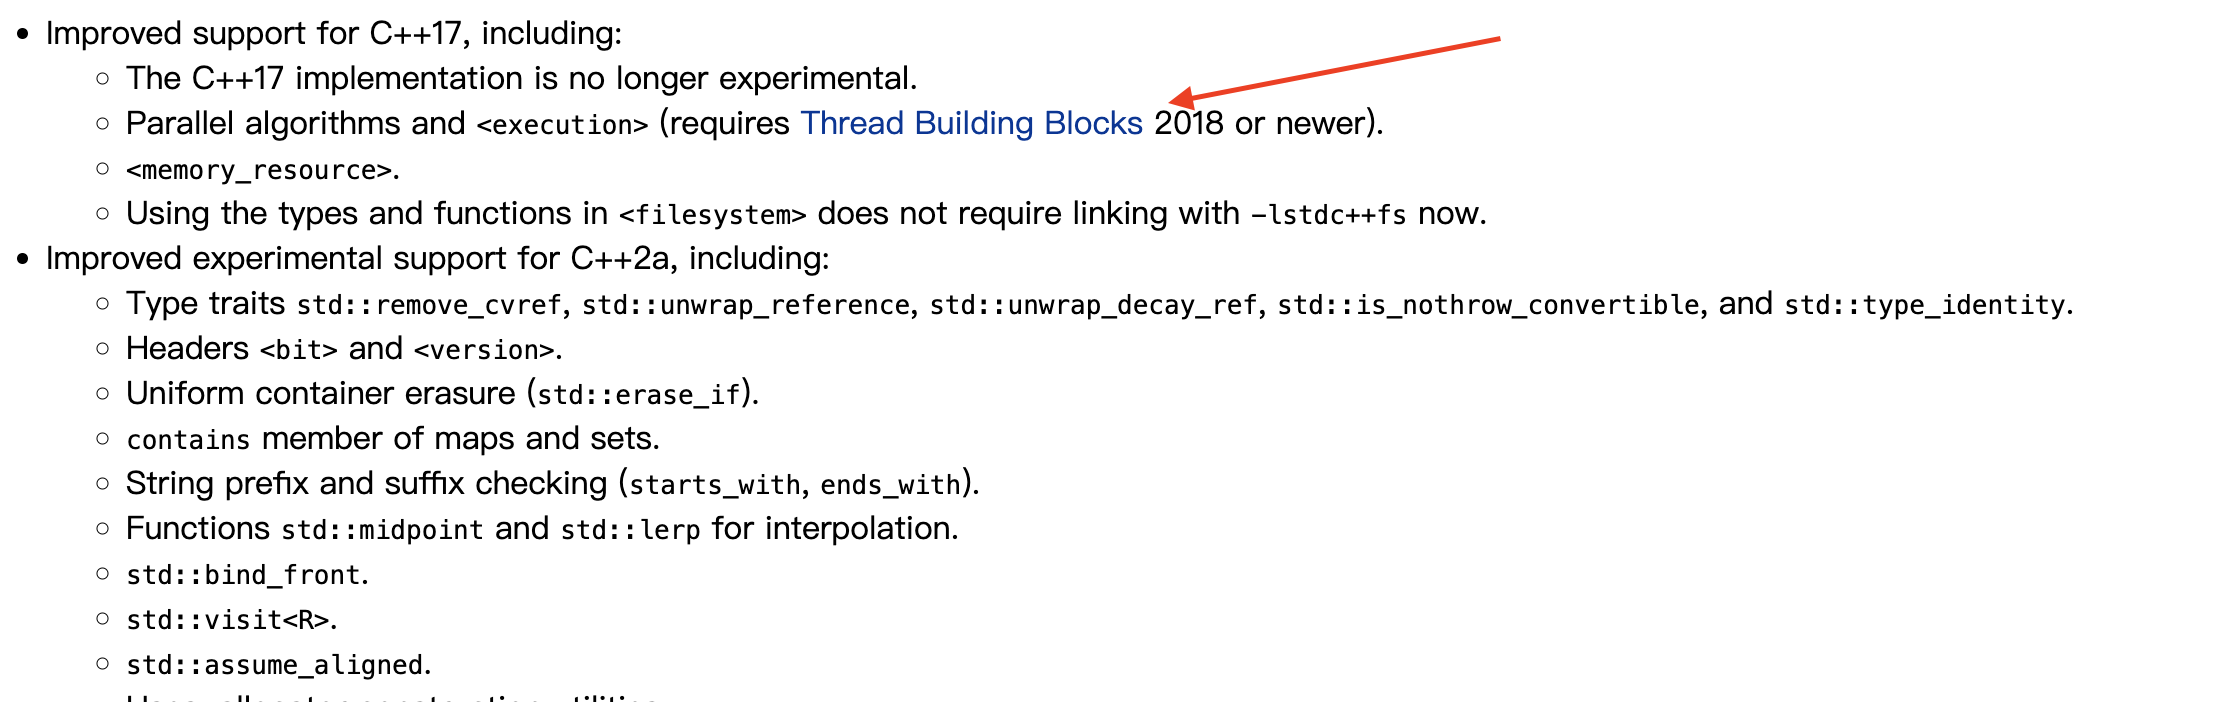
A partir do gcc 9 já é possível usar a biblioteca de algoritmos paralelos; vejamos o documento do gcc-9 abaixo.
Nele há uma informação muito importante: é necessário suporte a tbb.
A TBB é uma biblioteca C++ para programação paralela desenvolvida pela Intel. A TBB visa simplificar o desenvolvimento de software paralelo em processadores multinúcleo, fornecendo um conjunto de abstrações e modelos que facilitam a implementação de algoritmos paralelos.
1.Para usar a biblioteca de algoritmos paralelos no C++17 é preciso instalar a tbb; e o que acontece se não instalar?
Testei pessoalmente: compila e executa, apenas sem qualquer aceleração — o resultado é igual ao da execução não paralela original.
2.Como instalar a TBB?
Uma é a tbb oficial, chamada oneTBB.
A outra é uma tbb escrita por outra pessoa, chamada tbb.
A diferença é que esta adiciona um sistema de construção baseado em CMake.
Atualmente a oficial também suporta cmake, então recomendo usar a oficial.
A compilação também é muito simples:
3.Como usar
Quais são as mudanças em relação ao uso tradicional da STL?
1.Nível de interface
Na verdade é bem simples; por exemplo, o sort era:
e passa a ser:
Basta adicionar a política de execução (execution policy); há três opções:
std::execution::seq(execução sequencial):- Esta é a política de execução padrão, ou seja, se você não especificar uma política, o algoritmo usará execução sequencial.
- O algoritmo processa os elementos em sequência, sem paralelismo.
std::execution::par(execução paralela):- Usar esta política de execução ativa a execução paralela. O algoritmo tentará processar os elementos de forma paralela, aproveitando o processador multinúcleo.
std::execution::par_unseq(execução paralela e vetorizada):- Esta política permite que o algoritmo, além de paralelo, seja vetorizado (vectorization), o que significa usar o conjunto de instruções SIMD (Single Instruction, Multiple Data) para operações paralelas vetorizadas.
- Diferente de
std::execution::par,par_unseqpermite o processamento vetorial ao mesmo tempo em que paraleliza, aproveitando mais plenamente os recursos de paralelismo e vetorização do hardware.
2.Nível de cabeçalhos
É obrigatório incluir:
Se houver operações da tbb, podem ser incluídos os cabeçalhos da tbb, por exemplo: para definir o número de threads.
3.Nível de compilação
Ao compilar é preciso especificar as informações de link, por exemplo:
g++ -O3 -std=c++17 -Wall -Wextra -pedantic -I/usr/local/include/tbb -L /usr/local/lib/ -o main.out main.cc -ltbb
4.Teste de desempenho
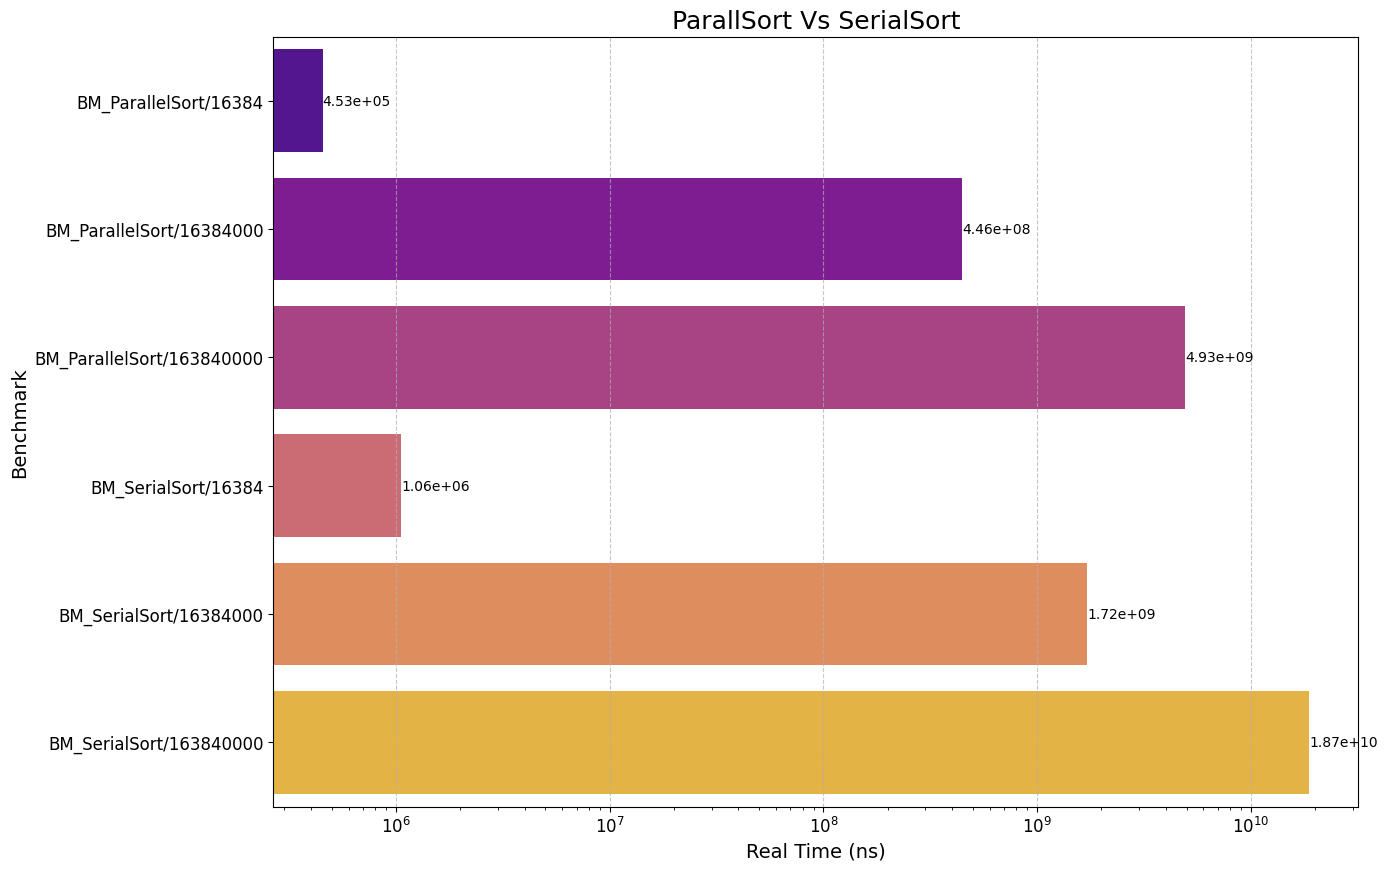
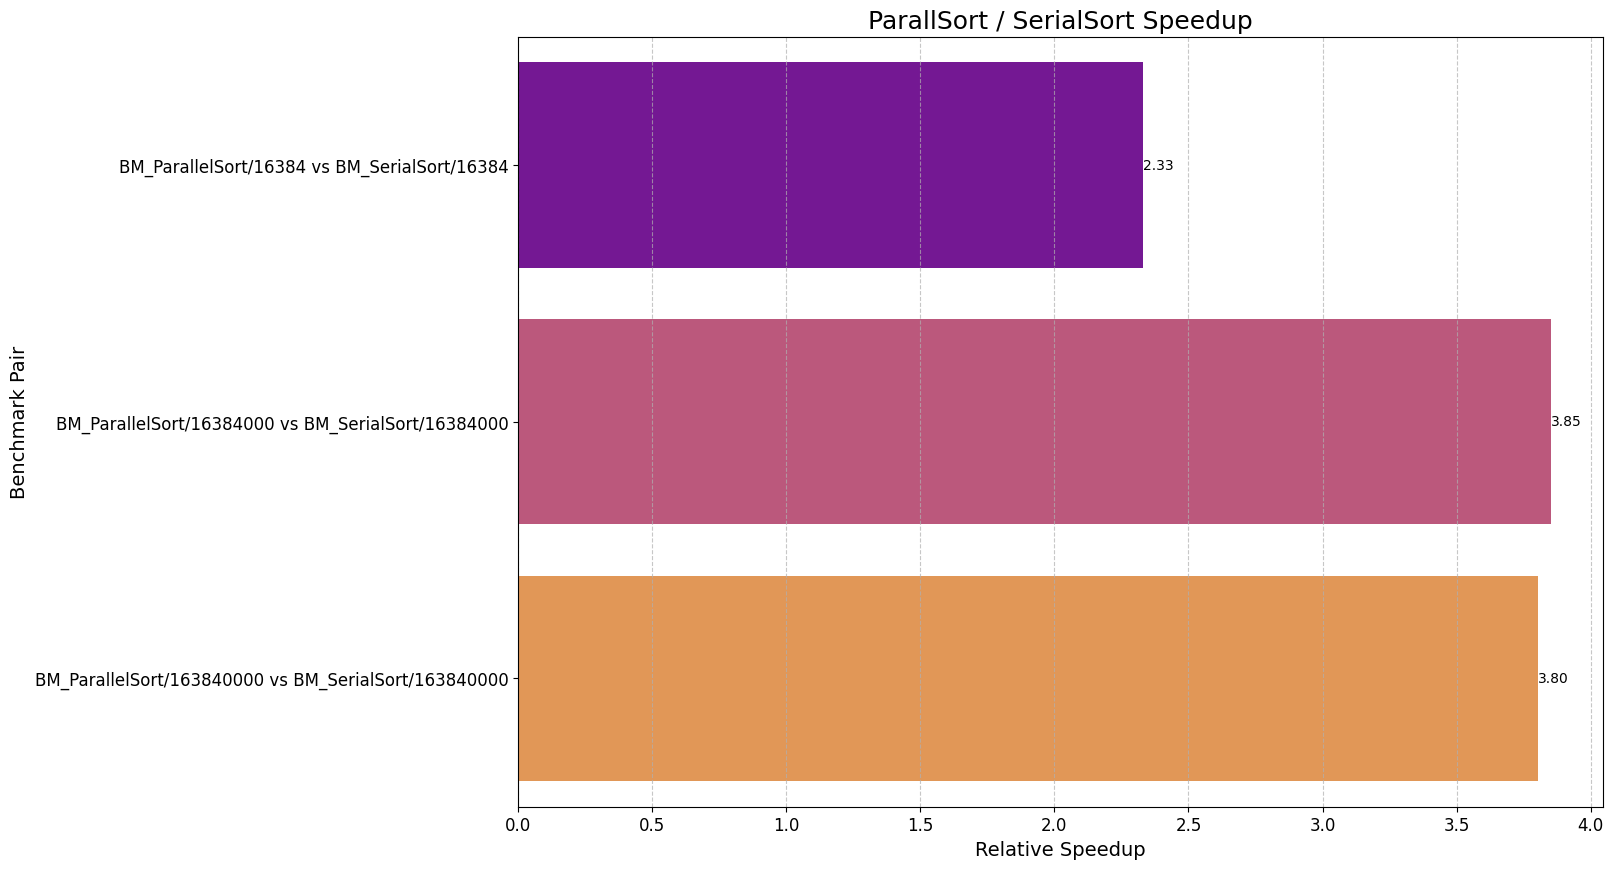
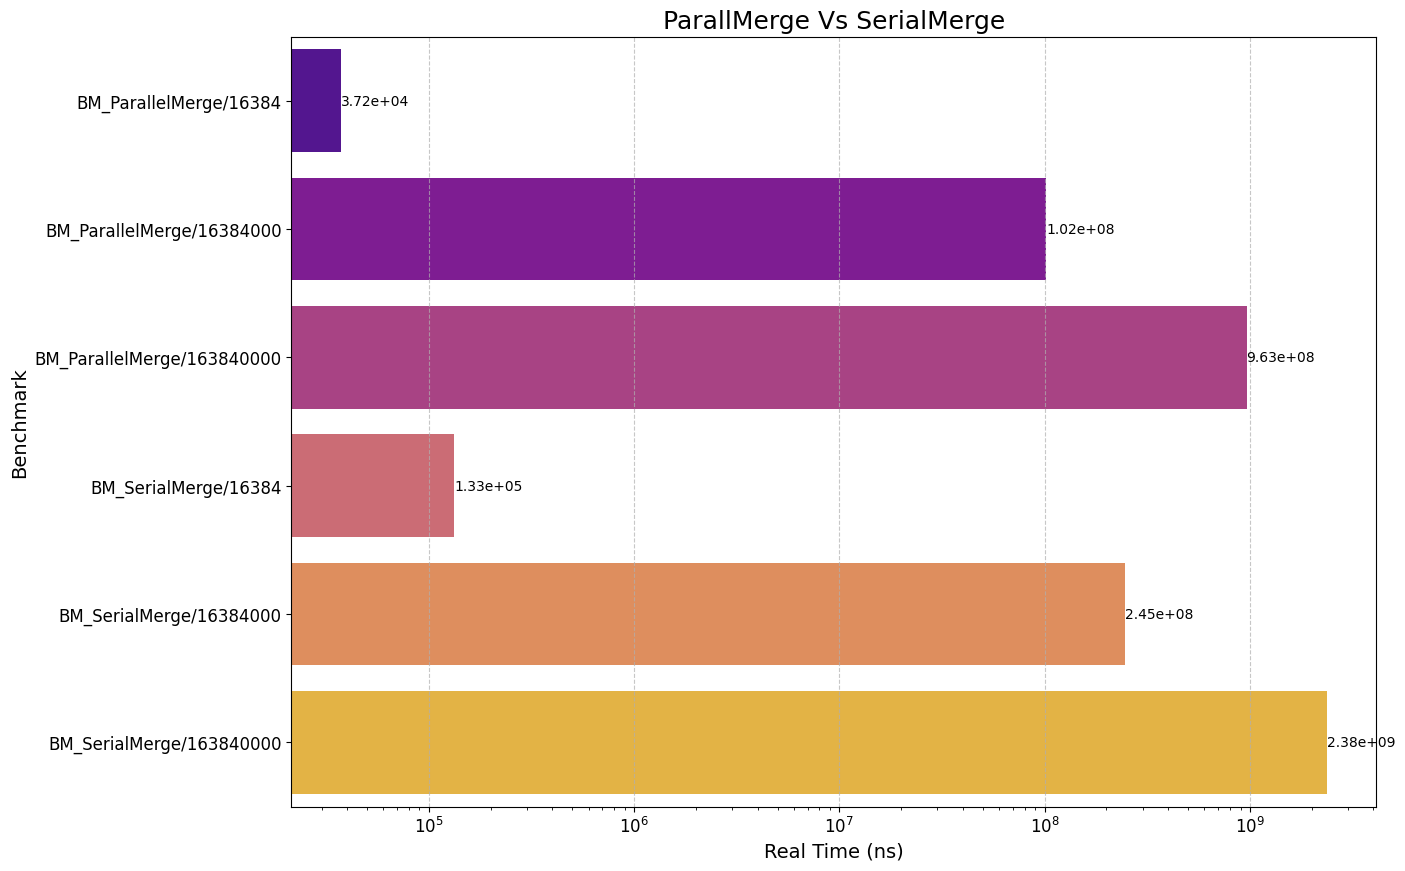
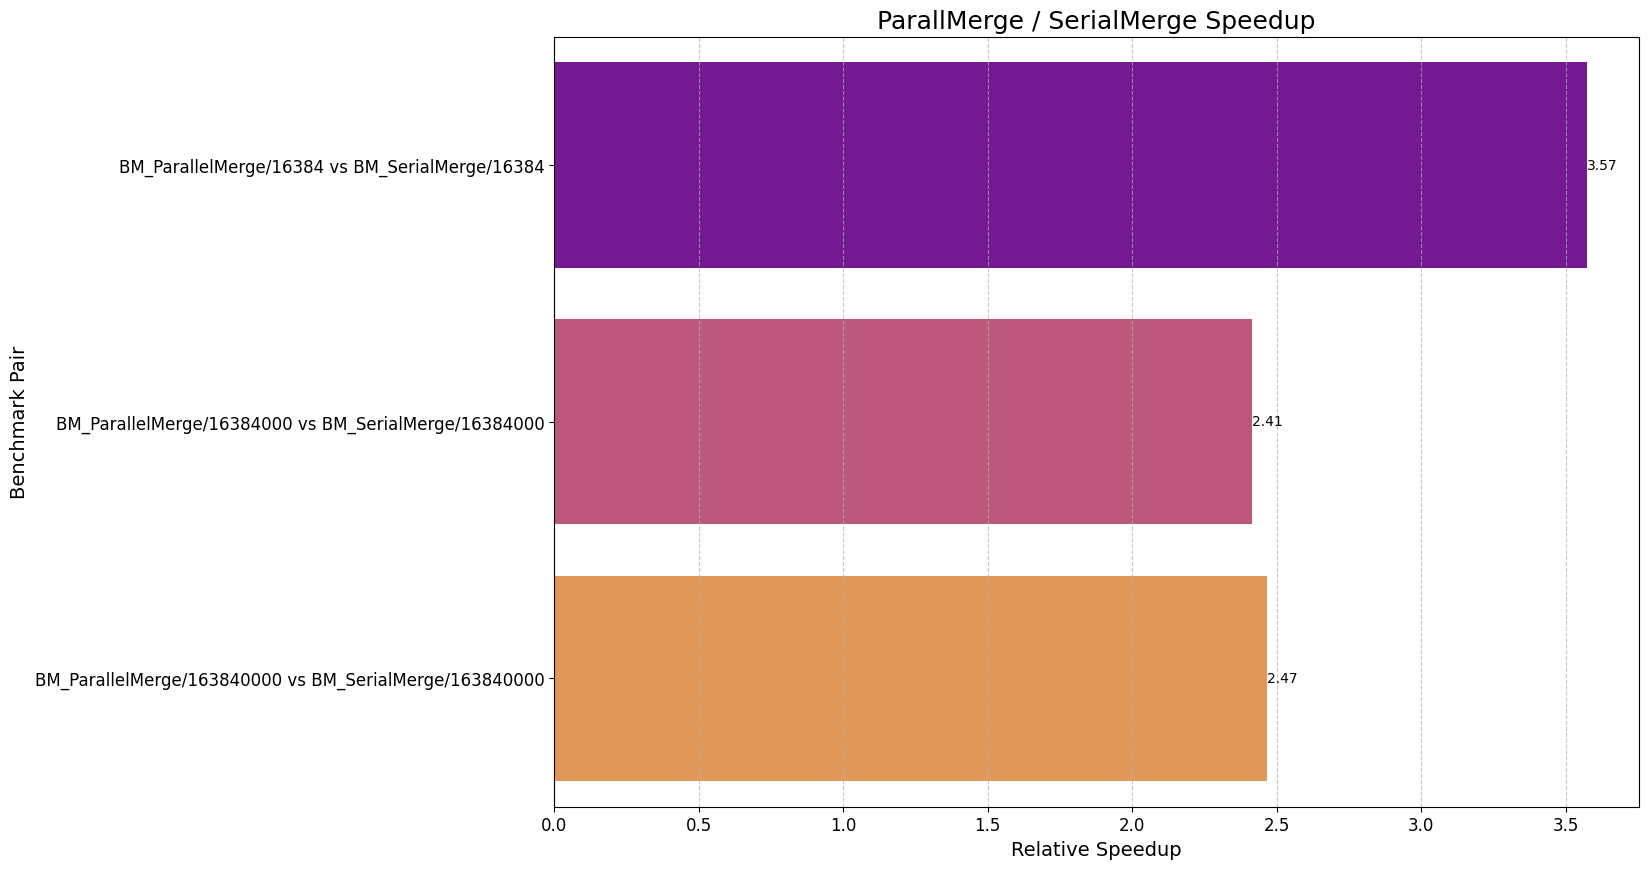
Recentemente trabalhei com sort e queria comparar o desempenho de merge e sort, então escrevi um benchmark com a seguinte lógica:
-
sort serial vs sort paralelo (política par)
-
merge serial vs merge paralelo (política par)
Intervalo de dados:
Os resultados de teste abaixo usam a política padrão de escalonamento de threads da tbb.
Grupo 1: sort paralelo/sort serial — dados detalhados e speedup
Grupo 2: merge paralelo/merge serial — dados detalhados e speedup
Documentação da tbb:
Para definir o número de threads, faça assim:
Tópicos relacionados
- Guia de C++ Concurrency in Action | C++那些事
- Depuração de Deadlocks em C++ | C++那些事
- Vetorização SIMD em C++ | C++那些事
- False Sharing e Linhas de Cache em C++ | C++那些事
- Depuração All-Stop multi-thread com GDB | C++那些事
- Detecção de Erros de Concorrência com Helgrind | C++那些事
- Princípio do event loop do libev | C++那些事
- Implementação interna de std::thread em C++ | C++那些事
- C++ std::thread e jthread | C++那些事
- Introdução a multi-thread em C++ | C++那些事