Последнее обновление:2026-10-12
Анализ исходников STL list
0. Введение
Версия исходников, которой соответствует разбор — gcc-4.9.1
1. list
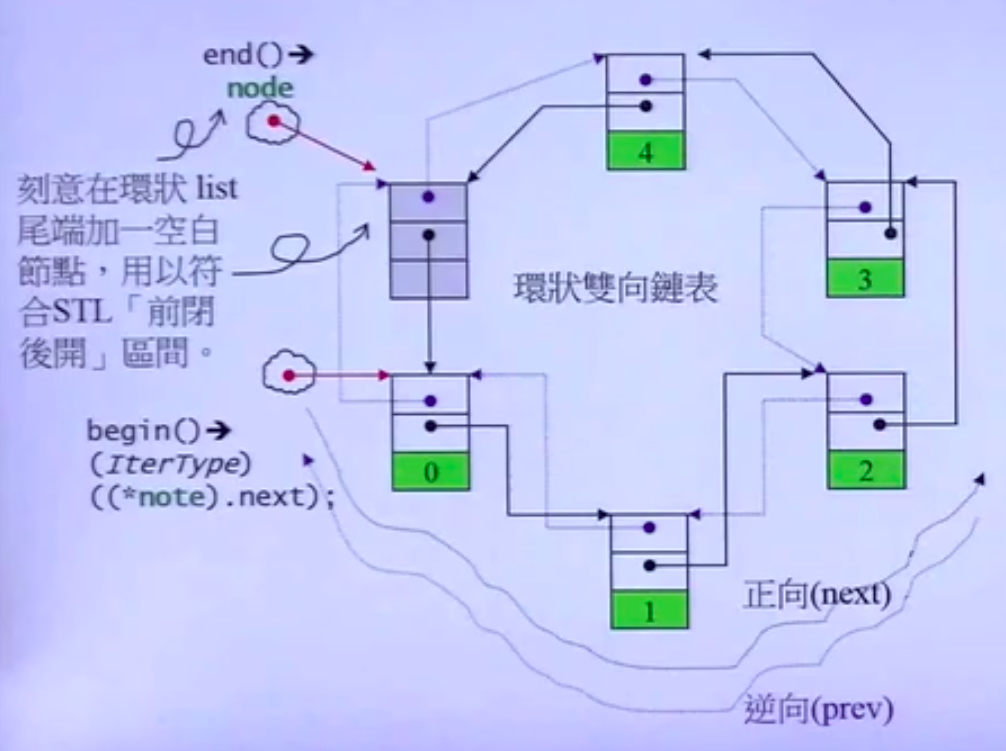
list — это двусвязный кольцевой список, его структура:
Нарисованная мной схема:
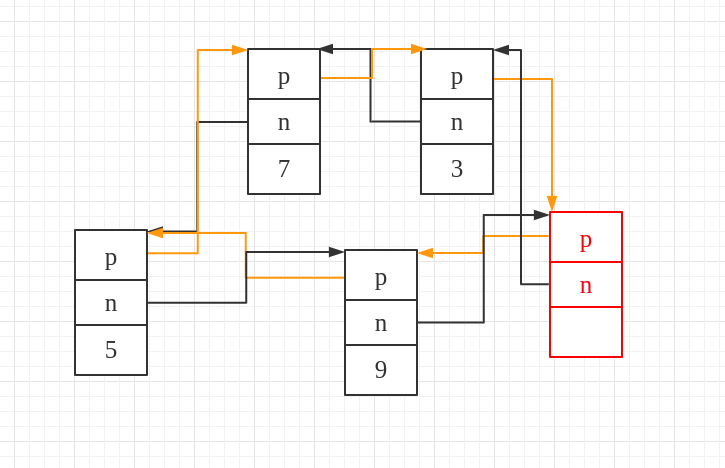
В двусвязный кольцевой список элементы вставляются, начиная с узла со значением 3; красная рамка обозначает последний узел (узел, на который указывает end()). Жёлтые линии — указатели на предшествующий узел, чёрные — на последующий узел.
1.1 Исходники list
1.1.1 Структура класса
 template<typename _Tp, typename _Alloc = std::allocator<_Tp> >
 class list : protected _List_base<_Tp, _Alloc>
 {

 }
list наследуется от _List_base.
1.1.2 Реализация двусвязного кольцевого списка
【Конструкторы】
(1)list без единого элемента
(2)list из n элементов с начальным значением
explicit list(size_type __n, const value_type &__value = value_type(),const allocator_type &__a = allocator_type()) : _Base(_Node_alloc_type(__a))
{ _M_fill_initialize(__n, __value); }
(3)инициализация list из диапазона
template<typename _InputIterator>
list(_InputIterator __first, _InputIterator __last,
     const allocator_type &__a = allocator_type())
        : _Base(_Node_alloc_type(__a)) {
    // Check whether it's an integral type.  If so, it's not an iterator.
    typedef typename std::__is_integer<_InputIterator>::__type _Integral;
    _M_initialize_dispatch(__first, __last, _Integral());
}
【Создание узла】
Что делает: создаёт новый узел и динамически выделяет память, возвращая узел.
_Node *_M_create_node(const value_type &__x) {
    _Node *__p = this->_M_get_node();
    __try
    {
        _M_get_Tp_allocator().construct
                (std::__addressof(__p->_M_data), __x);
    }
    __catch(...)
    {
        _M_put_node(__p);
        __throw_exception_again;
    }
    return __p;
}
Заметьте: внутри есть две важные функции — _M_get_node и _M_put_node; посмотрим их и обнаружим, что эти методы родом из базового класса, исходники таковы:
_List_node<_Tp> * _M_get_node() { return _M_impl._Node_alloc_type::allocate(1); }

void _M_put_node(_List_node<_Tp> *__p)   _GLIBCXX_NOEXCEPT
{ _M_impl._Node_alloc_type::deallocate(__p, 1); }
Они соответствуют созданию узла с динамическим выделением памяти; если в процессе создания выбрасывается исключение, память освобождается.
【Вставка узла】
Вставка узла включает:
- вставку в хвост n узлов с заданным значением узла — соответствующая функция
_M_fill_initialize
Используется в конструкторе list:
explicit list(size_type __n, const value_type &__value = value_type(),const allocator_type &__a = allocator_type()) : _Base(_Node_alloc_type(__a))
{ _M_fill_initialize(__n, __value); }
- вставку узла с заданным значением узла в заданную позицию — соответствующая функция
_M_insert
Часто используемые push_back и push_front внизу как раз вызывают функцию _M_insert.
Различие между этими двумя функциями:
- функция вставки двусвязного кольцевого списка
_M_hook(самая важная!!!)
Упомянутые выше push_back, push_front, _M_insert и даже insert реализованы на основе простейшей функции вставки двусвязного списка _M_hook.
Копнём глубже:
Исходники _M_fill_initialize таковы:
void _M_fill_initialize(size_type __n, const value_type &__x) {
    for (; __n; --__n)
        push_back(__x);
}
Исходники push_back:
_M_insert вставляет в заданную позицию узел с начальным значением x.
void _M_insert(iterator __position, const value_type &__x) {
    _Node *__tmp = _M_create_node(__x);
    __tmp->_M_hook(__position._M_node);
}
Реализация _M_hook находится в gcc-4.9.1/libstdc++-v3/src/c++98/list.cc; там же, конечно, и другие функции _List_node_base, например _M_unhook.
// 在指定的位置前插入this指向的节点
void_List_node_base::_M_hook(_List_node_base* const __position) _GLIBCXX_USE_NOEXCEPT
{
  this->_M_next = __position;
  this->_M_prev = __position->_M_prev;
  __position->_M_prev->_M_next = this;
  __position->_M_prev = this;
}
Итак, выше всё распалось на две функции. Подытожим этот код:
(1)вставка в заданную позицию узла с начальным значением x
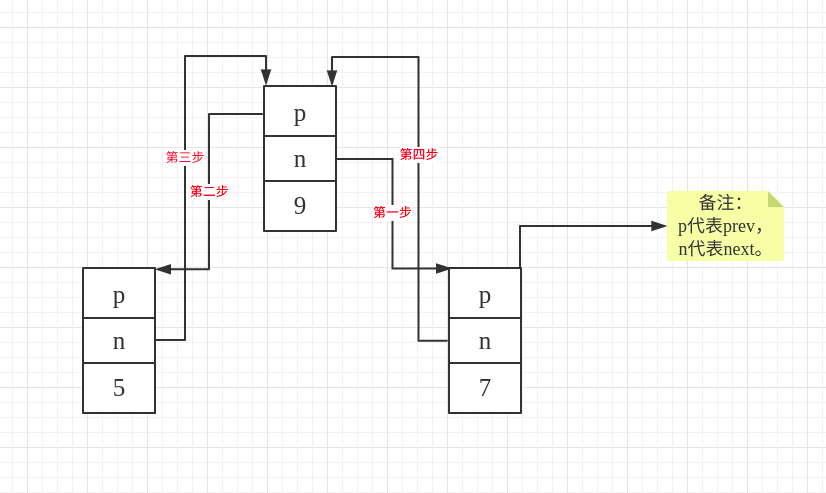
void _M_insert(iterator __position, const value_type &__x) {
    _Node *__tmp = _M_create_node(__x);
    __tmp->_M_next = __position;            // 第一步
    __tmp->_M_prev = __position->_M_prev;   // 第二步
    __position->_M_prev->_M_next = __tmp;   // 第三步
    __position->_M_prev = __tmp;            // 第四步
}
Такая вставка выполняется перед заданной позицией (в коде это выглядит так): например, нужно перед заданным узлом __position со значением 7 вставить узел со значением 9 (в коде это __tmp); ниже описан конкретный процесс вставки.
(2)вставка в конец n подряд узлов со значением x
void _M_fill_initialize(size_type __n, const value_type &__x) {
    for (; __n; --__n)
        _M_insert(end(), __x);
}
Глядя на код выше, вы, вероятно, вспомните insert — их три. Файл с реализацией insert — libstdc++-v3/include/bits/list.tcc.
- Первый: вставка узла с заданным значением элемента перед заданным итератором.
Реализация вызывает рассмотренную выше функцию _M_hook.
template<typename _Tp, typename _Alloc>
typename list<_Tp, _Alloc>::iterator
list<_Tp, _Alloc>::
#if __cplusplus >= 201103L
insert(const_iterator __position, const value_type& __x)
#else
insert(iterator __position, const value_type& __x)
#endif
{
  _Node* __tmp = _M_create_node(__x);
  __tmp->_M_hook(__position._M_const_cast()._M_node);
  return iterator(__tmp);
}
- Второй: вставка n узлов с заданным значением узла перед заданным итератором.
void insert(iterator __position, size_type __n, const value_type &__x) {
    list __tmp(__n, __x, get_allocator());
    splice(__position, __tmp);
}
Реализация сначала вызывает конструктор list, создавая list из n узлов с заданным значением.
explicit list(size_type __n, const value_type &__value = value_type(),const allocator_type &__a = allocator_type()) : _Base(_Node_alloc_type(__a))
{ _M_fill_initialize(__n, __value); }
Затем функцией splice выполняется вставка в текущий list из другого list.
void splice(iterator __position, list &__x)
{
    if (!__x.empty()) {
        _M_check_equal_allocators(__x);

        this->_M_transfer(__position._M_const_cast(),
                          __x.begin(), __x.end());
    }
}
Проследив код _M_transfer, узнаём:
// Moves the elements from [first,last) before position.
void
_M_transfer(iterator __position, iterator __first, iterator __last) {
    __position._M_node->_M_transfer(__first._M_node, __last._M_node);
}
Дальнейший анализ показывает, что она родом из базового класса list — _List_node_base, а реализация _M_transfer находится в gcc-4.9.1/libstdc++-v3/src/c++98/list.cc:
void _List_node_base::
_M_transfer(_List_node_base * const __first,
    _List_node_base * const __last) _GLIBCXX_USE_NOEXCEPT
{
  if (this != __last)
  {
      // Remove [first, last) from its old position.
      __last->_M_prev->_M_next  = this;
      __first->_M_prev->_M_next = __last;
      this->_M_prev->_M_next    = __first;

      // Splice [first, last) into its new position.
      _List_node_base* const __tmp = this->_M_prev;
      this->_M_prev                = __last->_M_prev;
      __last->_M_prev              = __first->_M_prev;
      __first->_M_prev             = __tmp;
  }
}
Всё та же схема:
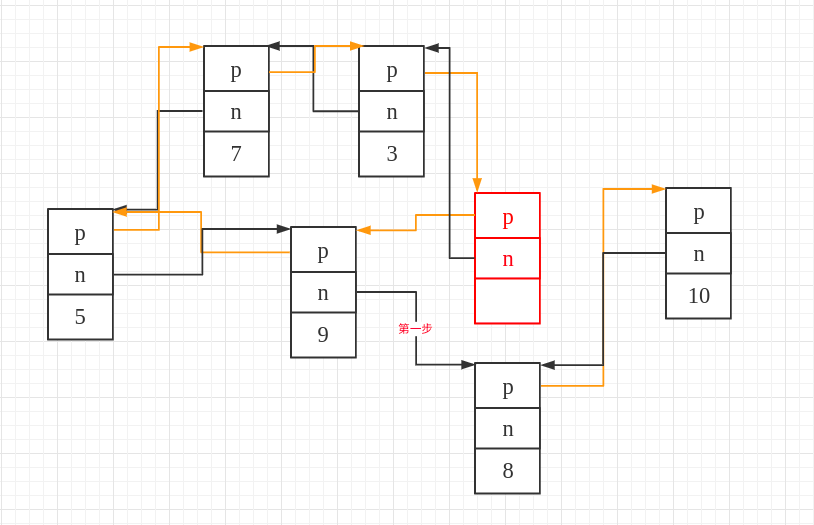
Из предыдущего анализа мы знаем: splice вставляет весь list, представленный схемой выше, перед заданным итератором. Например, мы хотим вставить перед двумя узлами ниже; конкретные графические шаги таковы:
Узел, представленный this, — узел со значением 8; схема ниже описывает вставку целого list между узлом 10 и узлом 8.
__last — узел в красной рамке; это узел, на который указывает end(), он нам не нужен, поэтому в дальнейшей обработке этот узел будет удалён из целого list.
__first — узел со значением 3 на схеме.
Шаг 1: сначала next-указатель последнего валидного узла, то есть узла перед красной рамкой, направляется на заданный узел 8.
Соответствующий код:
Шаг 2: next-указатель _last направляется на самого себя.

Соответствующий код:
Шаг 3: nex узла перед заданным итератором направляется на первый узел прежнего list (__first).
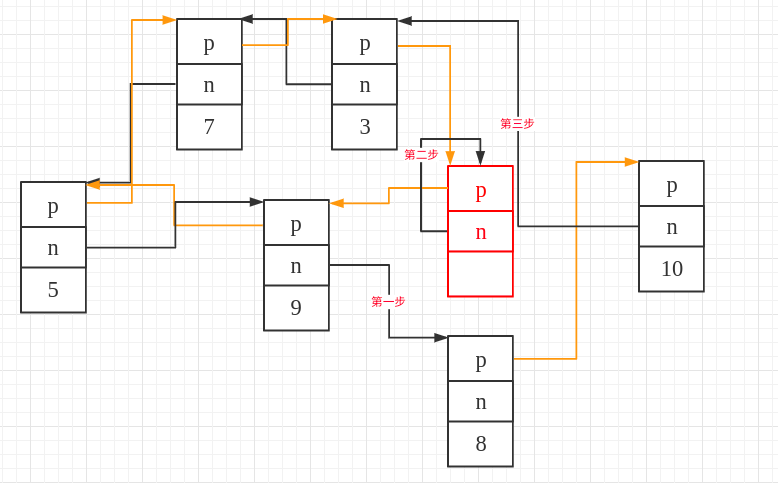
Соответствующий код:
Шаг 4: сохранить узел-предшественник заданного итератора (узел со значением 10 на схеме).
Шаг 5: узел-предшественник заданного итератора указывает на фактический последний узел прежнего list (узел перед end()).
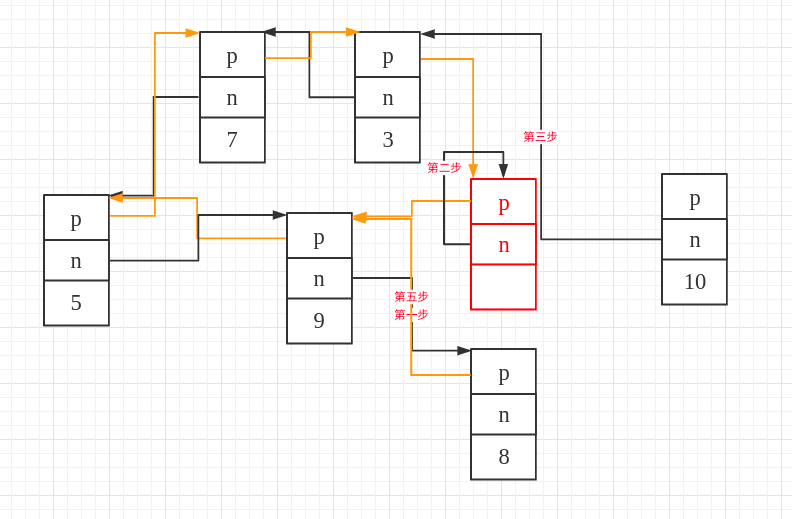
Соответствующий код:
Шаг 6: prev последнего узла прежнего list (узла, на который указывает end()) направить на самого себя.

Соответствующий код:
Шаг 7: prev первого узла прежнего list направить на узел, сохранённый на шаге 4.
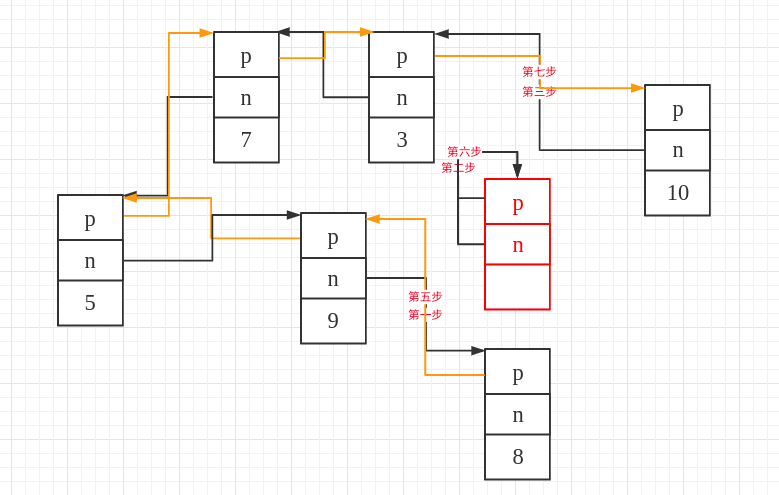
Соответствующий код:
Так, после этих семи шагов, вставка целого list перед узлом 8 и узлом 10 завершена.
- Третий: вставка данных из диапазона одного list перед заданным итератором.
template<typename _InputIterator>
void
insert(iterator __position, _InputIterator __first,
       _InputIterator __last) {
    list __tmp(__first, __last, get_allocator());
    splice(__position, __tmp);
}
Принцип тот же; разве что этот __tmp вызывает другой конструктор.
【Удаление узла】
- удаление заданного узла
Удаление заданного узла делится на два варианта: первый — удаление через итератор, второй — через значение элемента.
(1)удаление через итератор, соответствующая функция — erase
Реализации pop_front, pop_back, erase и remove внизу основаны на функции _M_erase.
this->_M_erase(begin());    // pop_front 不断删除起点的元素
this->_M_erase(iterator(this->_M_impl._M_node._M_prev)); // pop_back移除最后一个元素
В libstdc++-v3/include/bits/list.tcc:
erase(iterator __position)
#endif
{
  iterator __ret = iterator(__position._M_node->_M_next);
  _M_erase(__position._M_const_cast());
  return __ret;
}
(2)удаление по значению элемента, соответствующая функция — remove
Обработка особого случая: когда адрес удаляемого элемента совпадает с адресом итератора, он сначала сохраняется; в конце проверяется, не является ли сохранённый итератор end(), и если нет — удаляется. Внизу удаление по-прежнему выполняется через _M_erase.
template<typename _Tp, typename _Alloc>
void list<_Tp, _Alloc>::remove(const value_type& __value)
{
  iterator __first = begin();
  iterator __last = end();
  iterator __extra = __last;
  while (__first != __last)
  {
      iterator __next = __first;
      ++__next;
      if (*__first == __value)
        {
          // _GLIBCXX_RESOLVE_LIB_DEFECTS
          // 526. Is it undefined if a function in the standard changes
          // in parameters?
          if (std::__addressof(*__first) != std::__addressof(__value))
        _M_erase(__first);
          else
        __extra = __first;
        }
      __first = __next;
  }
  if (__extra != __last)
    _M_erase(__extra);
}
Помимо этого remove есть ещё remove_if — удаление по условию.
template<typename _Tp, typename _Alloc>
template <typename _Predicate>
void list<_Tp, _Alloc>::
remove_if(_Predicate __pred)
{
    iterator __first = begin();
    iterator __last = end();
    while (__first != __last)
    {
        iterator __next = __first;
        ++__next;
        if (__pred(*__first))
          _M_erase(__first);
        __first = __next;
    }
}
Достаточно убрать if из описанного выше remove и добавить внутри проверку.
Использование:
bool isone(int one) {
    return one==2;
}
int main() {
    list<int> t;
    t={3,4,0,2,0,10,10};
    for(auto i:t) cout<<i<<" ";  // 3 4 0 2 0 10 10
    cout<<endl;
    t.remove_if(isone);
    for(auto i:t) cout<<i<<" ";  // 3 4 0 0 10 10
    cout<<endl;
}
- удаление последовательности узлов
- удаление всех узлов, соответствующая функция
clear
(1)подробный разбор удаления заданного узла
_M_erase(iterator __position)
_GLIBCXX_NOEXCEPT
{
    __position._M_node->_M_unhook();
    _Node *__n = static_cast<_Node *>(__position._M_node);
#if __cplusplus >= 201103L
    _M_get_Node_allocator().destroy(__n);
#else
    _M_get_Tp_allocator().destroy(std::__addressof(__n->_M_data));
#endif
    _M_put_node(__n);       // 释放内存
}
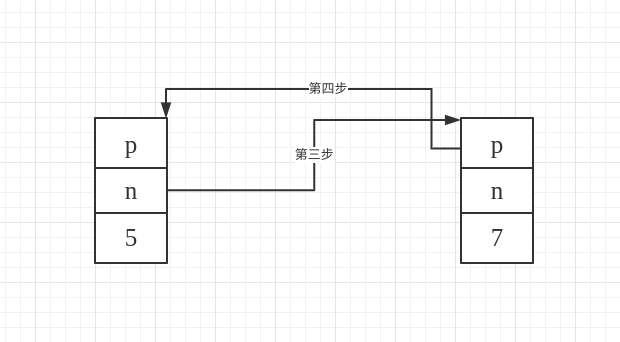
Реализация _M_unhook находится в gcc-4.9.1/libstdc++-v3/src/c++98/list.cc и выглядит так:
void _List_node_base::_M_unhook() _GLIBCXX_USE_NOEXCEPT
{
  _List_node_base* const __next_node = this->_M_next;   // 第一步:保存后继节点
  _List_node_base* const __prev_node = this->_M_prev;   // 第二步:保存前驱节点
  __prev_node->_M_next = __next_node;                   // 第三步:前驱节点的next指向后继节点
  __next_node->_M_prev = __prev_node;                   // 第四步:后继节点的prev指向前驱节点
}
Например: удаляем узел со значением 9; шаги 3 и 4 на схеме:
(2)подробный разбор удаления последовательности элементов
iterator
#if __cplusplus >= 201103L
erase(const_iterator __first, const_iterator __last) noexcept
#else
erase(iterator __first, iterator __last)
#endif
{
    while (__first != __last)
        __first = erase(__first);
    return __last._M_const_cast();
}
С помощью erase удаляются данные в заданном диапазоне итераторов.
(3)подробный разбор удаления всех элементов
Очищает элементы и выполняет инициализацию, возвращая list в состояние по умолчанию.
Реализация _M_clear находится в libstdc++-v3/include/bits/list.tcc:
_List_base<_Tp, _Alloc>::
_M_clear() _GLIBCXX_NOEXCEPT
{
  typedef _List_node<_Tp>  _Node;
  _Node* __cur = static_cast<_Node*>(_M_impl._M_node._M_next);
  while (__cur != &_M_impl._M_node)
    {
      _Node* __tmp = __cur;         // 保存节点
      __cur = static_cast<_Node*>(__cur->_M_next);  // 往后遍历
    #if __cplusplus >= 201103L
      _M_get_Node_allocator().destroy(__tmp);
    #else
      _M_get_Tp_allocator().destroy(std::__addressof(__tmp->_M_data));
    #endif
      _M_put_node(__tmp);   // 释放内存
    }
}
Реализация _M_init — все указатели на самого себя.
void _M_init()
_GLIBCXX_NOEXCEPT
{
    this->_M_impl._M_node._M_next = &this->_M_impl._M_node;
    this->_M_impl._M_node._M_prev = &this->_M_impl._M_node;
}
【Доступ к элементам】
Каждый метод реализован в двух версиях: ссылка и константная ссылка.
- front возвращает первый элемент
reference front()
_GLIBCXX_NOEXCEPT
{ return *begin(); }
const_reference
front() const
_GLIBCXX_NOEXCEPT
{ return *begin(); }
- возвращает последний элемент
reference
back()
_GLIBCXX_NOEXCEPT
{
    iterator __tmp = end();
    --__tmp;
    return *__tmp;
}
const_reference
back() const
_GLIBCXX_NOEXCEPT
{
    const_iterator __tmp = end();
    --__tmp;
    return *__tmp;
}
【Алгоритмы】
- unique
Удаляет из каждой группы подряд идущих равных элементов контейнера все элементы, кроме первого.
Обратите внимание: элемент удаляется из контейнера список только при сравнении с элементом, непосредственно соседним в контейнере список. Поэтому эта функция особенно полезна для отсортированных списков.
template<typename _Tp, typename _Alloc>
template <typename _BinaryPredicate>
  void
  list<_Tp, _Alloc>::
  unique(_BinaryPredicate __binary_pred)
  {
    iterator __first = begin();
    iterator __last = end();
    if (__first == __last)
  return;
    iterator __next = __first;
    while (++__next != __last)
  {
    // 满足条件就删除
    if (__binary_pred(*__first, *__next))
       // 删除
      _M_erase(__next);
    else
      __first = __next;
    __next = __first;
  }
  }
Пример:
// list::unique
#include <iostream>
#include <cmath>
#include <list>

// a binary predicate implemented as a function:
bool same_integral_part (double first, double second)
{ return ( int(first)==int(second) ); }

// a binary predicate implemented as a class:
struct is_near {
  bool operator() (double first, double second)
  { return (fabs(first-second)<5.0); }
};

int main ()
{
  double mydoubles[]={ 12.15,  2.72, 73.0,  12.77,  3.14,
                       12.77, 73.35, 72.25, 15.3,  72.25 };
  std::list<double> mylist (mydoubles,mydoubles+10);

  mylist.sort();             //  2.72,  3.14, 12.15, 12.77, 12.77,
                             // 15.3,  72.25, 72.25, 73.0,  73.35

  mylist.unique();           //  2.72,  3.14, 12.15, 12.77
                             // 15.3,  72.25, 73.0,  73.35

  mylist.unique (same_integral_part);  //  2.72,  3.14, 12.15
                                       // 15.3,  72.25, 73.0

  mylist.unique (is_near());           //  2.72, 12.15, 72.25

  std::cout << "mylist contains:";
  for (std::list<double>::iterator it=mylist.begin(); it!=mylist.end(); ++it)
    std::cout << ' ' << *it;
  std::cout << '\n';

  return 0;
}
Выше после сортировки удаляются все повторяющиеся элементы — остаётся по одному; без сортировки удаляются только повторяющиеся и при этом подряд идущие элементы.
- merge
Реализация merge использует рассмотренную выше функцию _M_transfer; пусть есть два list — list1 и list2. Элементы list1 сравниваются с элементами list2: если элемент list1 меньше элемента list2, итератор list1 инкрементируется без каких-либо действий; если же элемент list1 больше элемента list2, то итератор, соответствующий этому меньшему элементу list2, каждый раз передаётся в функцию _M_transfer, которая и вставляет меньший элемент list2 перед только что сравнивавшимся итератором list1; в конце концов все элементы оказываются вставленными в list1.
Когда list1 уже пройден до конца, а list2 — нет, достаточно один раз выполнить _M_transfer, вставив хвост list2 от текущего итератора до конца в конец list1.
template<typename _Tp, typename _Alloc>
void
list<_Tp, _Alloc>::
#if __cplusplus >= 201103L
merge(list&& __x)
#else
merge(list& __x)
#endif
{
  // _GLIBCXX_RESOLVE_LIB_DEFECTS
  // 300. list::merge() specification incomplete
  if (this != &__x)
  {
      _M_check_equal_allocators(__x);

      iterator __first1 = begin();
      iterator __last1 = end();
      iterator __first2 = __x.begin();
      iterator __last2 = __x.end();
      while (__first1 != __last1 && __first2 != __last2)
        if (*__first2 < *__first1)
         {
            iterator __next = __first2;
            _M_transfer(__first1, __first2, ++__next);
            __first2 = __next;
         }
        else
          ++__first1;
      if (__first2 != __last2)
        _M_transfer(__last1, __first2, __last2);
   }
}
Использование:
int main() {
    list<int> l1 = {2,3,5,7};
    list<int> l2 = {1,10,9,5};
    l1.sort();
    l2.sort();
    l1.merge(l2);
    for(auto i:l1) cout<<i<<" ";    // 1 2 3 5 5 7 9 10
    return 0;
}
- sort
Поскольку собственный алгоритм сортировки STL sort принимает входные итераторы произвольного доступа, а у двусвязного контейнера list способ доступа — двунаправленные итераторы, использовать собственный sort из STL нельзя — приходится определять собственный алгоритм сортировки под свой способ доступа. Из разбора исходников видно, что идея этого алгоритма сортировки похожа на сортировку слиянием.
В sort вызывается такой splice:
void splice(const_iterator __position, list& __x, const_iterator __i) noexcept
{ splice(__position, std::move(__x), __i); }
Разбираем дальше:
void
splice(iterator __position, list &__x, iterator __i)
{
    iterator __j = __i._M_const_cast();
    ++__j;
    if (__position == __i || __position == __j)
        return;

    if (this != &__x)
        _M_check_equal_allocators(__x);

    this->(__position._M_const_cast(),
                      __i._M_const_cast(), __j);
}
В конце вызывается _M_transfer.
В sort есть ещё функция swap, выполняющая обмен двух списков; код реализации находится в gcc-4.9.1/libstdc++-v3/src/c++98/list.cc:
void
_List_node_base::swap(_List_node_base& __x,
          _List_node_base& __y) _GLIBCXX_USE_NOEXCEPT
{
      if ( __x._M_next != &__x )
    {
      if ( __y._M_next != &__y )
        {
          // Both __x and __y are not empty.
          std::swap(__x._M_next,__y._M_next);
          std::swap(__x._M_prev,__y._M_prev);
          __x._M_next->_M_prev = __x._M_prev->_M_next = &__x;
          __y._M_next->_M_prev = __y._M_prev->_M_next = &__y;
        }
      else
        {
              // __x is not empty, __y is empty.
              __y._M_next = __x._M_next;
              __y._M_prev = __x._M_prev;
              __y._M_next->_M_prev = __y._M_prev->_M_next = &__y;
              __x._M_next = __x._M_prev = &__x;
            }
        }
      else if ( __y._M_next != &__y )
        {
          // __x is empty, __y is not empty.
          __x._M_next = __y._M_next;
          __x._M_prev = __y._M_prev;
          __x._M_next->_M_prev = __x._M_prev->_M_next = &__x;
          __y._M_next = __y._M_prev = &__y;
        }
}
Идея реализации: проверяется, пусты ли оба списка или нет, а затем изменяются указатели next и prev.
Теперь посмотрим на мощный sort:
template<typename _Tp, typename _Alloc>
void
list<_Tp, _Alloc>::
sort() {
    // Do nothing if the list has length 0 or 1.
    if (this->_M_impl._M_node._M_next != &this->_M_impl._M_node
        && this->_M_impl._M_node._M_next->_M_next != &this->_M_impl._M_node) {
        list __carry; // 辅助链表,用于从a中提取元素以及临时保存两个链表的合并结果
        list __tmp[64]; // 保存着当前每一个归并层次的结果, i号链表保存的元素个数为2的i次方或者0
        list *__fill = &__tmp[0]; // 表示当前最大归并排序的层次,while循环之后__fill变成log2(list.size())
        list *__counter;

        do {
            __carry.splice(__carry.begin(), *this, begin()); //把当前链表的第一个节点放在carry链表头

            for (__counter = &__tmp[0];
                 __counter != __fill && !__counter->empty();
                 ++__counter) {
                __counter->merge(__carry);  // 两个有序链表合并
                __carry.swap(*__counter); // 类似于交换链表carry和counter[i]内容
            }
            __carry.swap(*__counter); // 类似于交换链表carry和counter[i]内容
            if (__counter == __fill)
                ++__fill;
        } while (!empty());
        // 每两个进行归并,依次网上,直到最后*(__fill-1)保存最后的排序结果。然后交换到当前list中。
        for (__counter = &__tmp[1]; __counter != __fill; ++__counter)
            __counter->merge(*(__counter - 1));
        swap(*(__fill - 1));
    }
}
Выше код выглядит довольно сложным; поиски в сети показали, что в G2.9 он таков:
template <class T, class Alloc>
void list<T, Alloc> :: sort(){
    // 判断链表是否为空或者只有一个元素
    if(node->next == node || link_type(node->next)->next == node){
        return;
    }

    list<T, Alloc> carry;
    list<T, alloc> counter[64];
    int fill = 0;
    while(!empty()){
        carry.splice(carry.begin(), *this, begin());
        int i = 0;
        while(i < fill && !counter[i].empty()){
            counter[i].merge(carry);
            carry.swap(counter[i++]);
        }
        carry.swap(counter[i]);
        if(i == fill){
            ++fill;
        }
    }

    for(int i = 1; i < fill; ++i){
        counter[i].merge(counter[i-1]);
    }
    swap(counter[fill-1]);
}
Соответствующая внешняя реализация:
void sortList(list<int> &l) {
    if (l.size() <= 1) {
        return;
    }
    list<int> carry;       // 辅助链表,用于从a中提取元素以及临时保存两个链表的合并结果
    list<int> counter[64]; // 保存着当前每一个归并层次的结果, i号链表保存的元素个数为2的i次方或者0
    int fill = 0;          // 表示当前最大归并排序的层次,while循环之后fill变成log2(a.size())

    while (!l.empty()) {
        carry.splice(carry.begin(), l, l.begin()); // 将链表a中的第一个元素移动至carry开头
        int i = 0;
        // 从小往大不断合并非空归并层次直至遇到空层或者到达当前最大归并层次
        while (i < fill && !counter[i].empty()) {
            counter[i].merge(carry);    // 链表合并,结果链表是有序的,必须保证合并前两个链表是有序的
            carry.swap(counter[i++]);   // 链表元素互换
        }
        carry.swap(counter[i]);
        if (i == fill) {       // i到达当前最大归并层次,说明得增加一层
            ++fill;
        }
    }

    for (int i = 1; i < fill; ++i) {  // 将所有归并层次的结果合并得到最终结果counter[fill - 1]
        counter[i].merge(counter[i - 1]);
    }
    l.swap(counter[fill - 1]);
}
По этому материалу можно обратиться к
Там приведены подробные пошаговые схемы.
Перепишем ещё раз G4.9 в виде соответствующей внешней реализации:
void sortList1(list<int> &l) {
    typedef list<int> list;
    if (l.size() <= 1) {
        return;
    }
    list __carry;
    list __tmp[64];
    list *__fill = &__tmp[0];
    list *__counter;
    do {
        __carry.splice(__carry.begin(), l, l.begin());
        for (__counter = &__tmp[0];
             __counter != __fill && !__counter->empty();
             ++__counter) {
            __counter->merge(__carry);
            __carry.swap(*__counter);
        }
        __carry.swap(*__counter);
        if (__counter == __fill) ++__fill;
    } while (!l.empty());

    for (__counter = &__tmp[1]; __counter != __fill; ++__counter)
        __counter->merge(*(__counter - 1));

    l.swap(*(__fill - 1));
}
Использование:
int main() {
    list<int> l = {7, 5, 8, 1};
    cout << "===============排序前==============" << endl;
    for (auto i:l) cout << i << " ";
    cout << endl;
    sortList1(l);
    cout << "===============排序后==============" << endl;
    for (auto i:l) cout << i << " ";
    cout << endl;

    return 0;
}
【Перегрузка операторов】
template<typename _Tp, typename _Alloc>
inline bool
operator==(const list<_Tp, _Alloc> &__x, const list<_Tp, _Alloc> &__y) {
    typedef typename list<_Tp, _Alloc>::const_iterator const_iterator;
    const_iterator __end1 = __x.end();
    const_iterator __end2 = __y.end();

    const_iterator __i1 = __x.begin();
    const_iterator __i2 = __y.begin();
    while (__i1 != __end1 && __i2 != __end2 && *__i1 == *__i2) {
        ++__i1;
        ++__i2;
    }
    return __i1 == __end1 && __i2 == __end2;
}
Идея реализации: в цикле проверять, достигли ли оба итератора конца.
Дальше идёт перегрузка остальных операторов — она довольно проста, так что останавливаться не будем. Среди них lexicographical_compare реализован в c++-v3/src/c++98/stl_algobase.h; эта функция проверяет в лексикографическом порядке, что [frist1,last1) меньше [first2,last2). Для сравнения функция использует opeartor< либо comp. Поведение аналогично следующему: если длины двух последовательностей различаются и короткая последовательность полностью совпадает с началом длинной, например example и examplee, то более длинная лексикографически больше короткой.
template <class InputIterator1, class InputIterator2>
bool lexicographical_compare (InputIterator1 first1, InputIterator1 last1,
InputIterator2 first2, InputIterator2 last2)
{
    while (first1!=last1)
    {
        if (first2==last2 || *first2<*first1) return false;
        else if (*first1<*first2) return true;
        ++first1; ++first2;
    }
    return (first2!=last2);
}
Использование:
int main() {
     vector<char> v1{'h','e','l','l','o'};
    vector<char> v2{'h','e','l','l','o','o'};
    vector<char> v3{'h','e','l','m','o'};
    cout<<"v1=";
    for(char i:v1)
        cout<<i<<" ";
    cout<<endl;
    cout<<"v2=";
    for(char i:v2)
        cout<<i<<" ";
    cout<<endl;
    cout<<"v3=";
    for(char i:v3)
        cout<<i<<" ";
    cout<<endl;

    if(lexicographical_compare(v1.begin(),v1.end(),v2.begin(),v2.end()))
        cout<<"v1 is less than v2 "<<endl;
    else
        cout<<"v2 is less than v1 "<<endl;

    if(lexicographical_compare(v1.begin(),v1.end(),v3.begin(),v3.end()))
        cout<<"v1 is less than v3 "<<endl;
    else
        cout<<"v3 is less than v1 "<<endl;
}
Остальные перегруженные операторы таковы:
template<typename _Tp, typename _Alloc>
inline bool
operator<(const list<_Tp, _Alloc> &__x, const list<_Tp, _Alloc> &__y) {
    return std::lexicographical_compare(__x.begin(), __x.end(),
                                        __y.begin(), __y.end());
}

/// Based on operator==
template<typename _Tp, typename _Alloc>
inline bool
operator!=(const list<_Tp, _Alloc> &__x, const list<_Tp, _Alloc> &__y) { return !(__x == __y); }

/// Based on operator<
template<typename _Tp, typename _Alloc>
inline bool
operator>(const list<_Tp, _Alloc> &__x, const list<_Tp, _Alloc> &__y) { return __y < __x; }

/// Based on operator<
template<typename _Tp, typename _Alloc>
inline bool
operator<=(const list<_Tp, _Alloc> &__x, const list<_Tp, _Alloc> &__y) { return !(__y < __x); }

/// Based on operator<
template<typename _Tp, typename _Alloc>
inline bool
operator>=(const list<_Tp, _Alloc> &__x, const list<_Tp, _Alloc> &__y) { return !(__x < __y); }
1.2 Исходники базового класса list
В _list_base есть структура _List_impl, а внутри _List_impl — List_node_base.
class _List_base
{
protected:
  typedef typename _Alloc::template rebind<_List_node<_Tp> >::other
    _Node_alloc_type;

  typedef typename _Alloc::template rebind<_Tp>::other _Tp_alloc_type;

  struct _List_impl
  : public _Node_alloc_type
  {
    __detail::_List_node_base _M_node;

    _List_impl()
    : _Node_alloc_type(), _M_node()
    { }

    _List_impl(const _Node_alloc_type& __a) _GLIBCXX_NOEXCEPT
    : _Node_alloc_type(__a), _M_node()
    { }

    #if __cplusplus >= 201103L
    _List_impl(_Node_alloc_type&& __a) _GLIBCXX_NOEXCEPT
    : _Node_alloc_type(std::move(__a)), _M_node()
    { }
    #endif
  };

  _List_impl _M_impl;
};
В итоге получается такая схема:
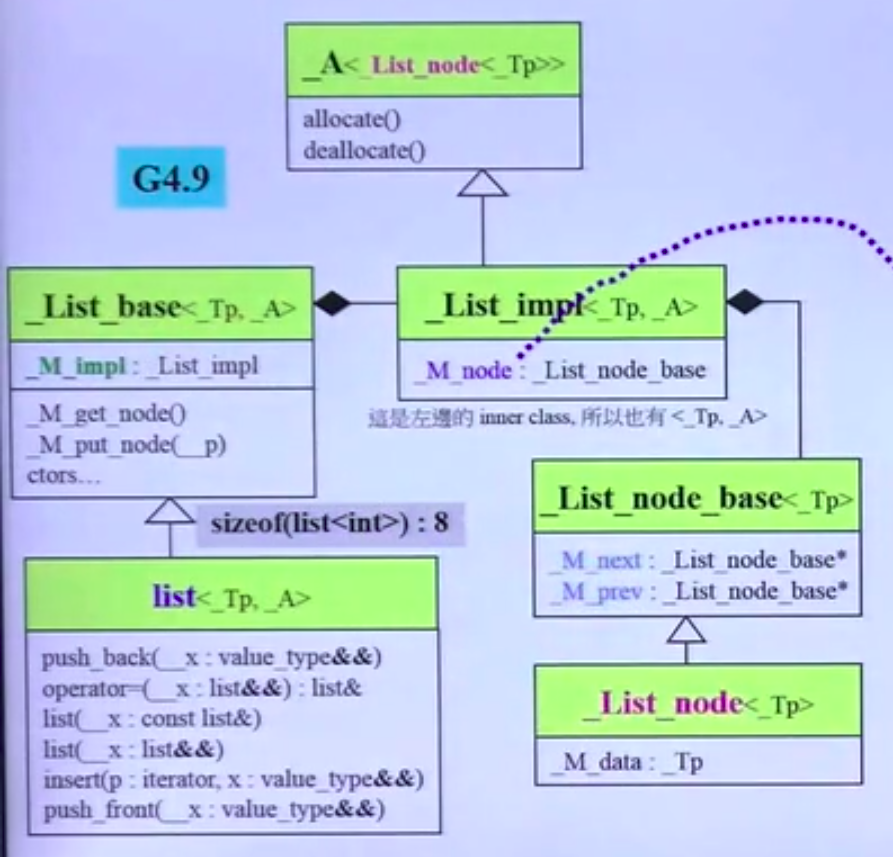
Поэтому если вычислить:
Причина:
sizeof у list равен 1, поэтому sizeof приходит из базового класса _list_base, в _list_base есть структура _List_impl, а внутри _List_impl — _List_node_base.
Мы знаем, что в _List_node_base два указателя; на 64-битной системе каждый по 8 байт — всего 16 байт.
2. Разбор iterator у list
2.1 iterator
Определение итератора list
template<typename _Tp>
struct _List_iterator
{
  typedef _List_iterator<_Tp>                _Self;
  typedef _List_node<_Tp>                    _Node;

  typedef ptrdiff_t                          difference_type;
  typedef std::bidirectional_iterator_tag    iterator_category;
  typedef _Tp                                value_type;
  typedef _Tp*                               pointer;
  typedef _Tp&                               reference;

   // The only member points to the %list element.
   __detail::_List_node_base* _M_node;
   //  _List_node(节点的数据部分) -> _List_node_base(前指针与后指针)

  _List_iterator() _GLIBCXX_NOEXCEPT
  : _M_node() { }

  explicit
  _List_iterator(__detail::_List_node_base* __x) _GLIBCXX_NOEXCEPT
  : _M_node(__x) { }

  _Self
  _M_const_cast() const _GLIBCXX_NOEXCEPT
  { return *this; }

  // The only member points to the %list element.
  __detail::_List_node_base* _M_node;
};
Внутренние перегруженные функции:
// Must downcast from _List_node_base to _List_node to get to _M_data.
// 重载*操作符
reference operator*() const _GLIBCXX_NOEXCEPT
{
    return static_cast<_Node*>(_M_node)->_M_data;
}

// 重载->操作符
pointer operator->() const _GLIBCXX_NOEXCEPT
{
    return std::__addressof(static_cast<_Node*>(_M_node)->_M_data);
}

// 重载前置++操作符  ++i
_Self& operator++() _GLIBCXX_NOEXCEPT
{
    _M_node = _M_node->_M_next;
    return *this;
}

// 重载后置++操作符 i++
_Self operator++(int) _GLIBCXX_NOEXCEPT
{
    _Self __tmp = *this;             // 记录原值  *调用的是拷贝构造函数
    _M_node = _M_node->_M_next;      // 进行操作
    return __tmp;                    // 返回原值
}

// 重载前置--操作符  --i
_Self& operator--() _GLIBCXX_NOEXCEPT
{
    _M_node = _M_node->_M_prev;
    return *this;
}
// 重载后置--操作符  --i
_Self operator--(int) _GLIBCXX_NOEXCEPT
{
    _Self __tmp = *this;
    _M_node = _M_node->_M_prev;
    return __tmp;
}
// 重载++操作符
bool operator==(const _Self& __x) const _GLIBCXX_NOEXCEPT
{
    return _M_node == __x._M_node;
}
// 重载!=操作符
bool operator!=(const _Self& __x) const _GLIBCXX_NOEXCEPT
{
    return _M_node != __x._M_node;
}
2.2 Дизайн узла
_List_node внутри итератора — здесь видно, что он наследуется от _List_node_base.
_List_node хранит данные
_List_node_base хранит указатели вперёд и назад
/// An actual node in the %list.
template<typename _Tp>
struct _List_node : public __detail::_List_node_base
{
  ///< User's data.
  _Tp _M_data;

#if __cplusplus >= 201103L
  template<typename... _Args>
    _List_node(_Args&&... __args)
: __detail::_List_node_base(), _M_data(std::forward<_Args>(__args)...)
    { }
#endif
};
Код _List_node_base:
namespace __detail
{
    _GLIBCXX_BEGIN_NAMESPACE_VERSION
    /// Common part of a node in the %list.
    struct _List_node_base
    {
      _List_node_base* _M_next;
      _List_node_base* _M_prev;

      static void
      swap(_List_node_base& __x, _List_node_base& __y) _GLIBCXX_USE_NOEXCEPT;

      void
      _M_transfer(_List_node_base* const __first,
          _List_node_base* const __last) _GLIBCXX_USE_NOEXCEPT;

      void
      _M_reverse() _GLIBCXX_USE_NOEXCEPT;

      void
      _M_hook(_List_node_base* const __position) _GLIBCXX_USE_NOEXCEPT;

      void
      _M_unhook() _GLIBCXX_USE_NOEXCEPT;
    };

    _GLIBCXX_END_NAMESPACE_VERSION
} // namespace detail
При разработке итераторов всегда соблюдается принцип полуоткрытых интервалов: например, iter->begin() указывает на первый элемент, а iter->end() — на элемент, следующий за фактическим последним; поэтому итоговый дизайн намеренно добавляет в конец кольцевого list пустой узел, чтобы соответствовать принципу STL «замкнуто слева, открыто справа».
Похожие темы
- Анализ исходников STL array | C++那些事
- Глубокий анализ STL string | C++那些事
- Разбор вопросов собеседования про STL string | C++那些事
- Анализ исходников STL deque | C++那些事
- Оптимизация пустого базового класса EBO в STL | C++那些事
- Реализация хеш-таблицы своими руками | C++那些事
- Хеш-таблица STL hashtable | C++那些事
- Анализ исходников STL итераторов | C++那些事
- STL map и multimap | C++那些事
- Анализ исходников STL queue и stack | C++那些事